Anthropic, LLM으로 더 큰 규모의 소프트웨어 검증이 가능해지고 있다
Anthropic과 Theorem이 2026년 10월 22일, Claude로 오픈소스 라이브러리 123개의 테스트 진입점 239개를 정형 검증한 연구 공개
기존 퍼징 테스트를 바탕으로, 정해진 조건에서 프로그램이 비정상 종료하지 않는다는 점을 수학적으로 증명
퍼징 테스트를 수학적 증명으로
퍼징은 다양한 입력을 반복해서 넣으며 버그를 찾는 방식
이번에는 기존 테스트에서 검사하던 내용을 수식으로 정리하고, 64MB 미만의 어떤 입력을 넣어도 프로그램이 비정상 종료하지 않는지 검증
Claude가 쓰고 Rocq가 확인
라이브러리와 테스트를 RISC-V 실행 파일로 컴파일
메모리를 잘못 읽거나 쓰는 오류를 감지하면 실행을 멈추도록 AddressSanitizer 추가
Claude가 CPU와 Linux의 동작을 수학적으로 표현한 모델을 바탕으로 증명 코드 작성
Rocq 커널이 그 증명이 맞는지 검사
버그가 발견되면 고친 뒤 다시 증명
몇 주 동안 작성한 증명 코드는 약 1억 8,000만 줄
검증 범위와 남은 한계
RISC-V와 Linux에서 musl libc를 정적으로 연결한 단일 스레드 프로그램을 대상으로 검증
사용할 수 있는 메모리 크기도 고정
테스트를 시작하는 지점에서 실행할 수 있는 코드가 검증 대상
예를 들어 압축 후 복원 결과가 원본과 같은지 확인하는 테스트라면, 비정상 종료가 없다는 증명으로 이 동작도 확인 가능
검증 결과를 실제 프로그램에 적용하려면 CPU와 운영체제 모델이 실제 동작과 일치해야 함
나머지 테스트 진입점과 AddressSanitizer가 놓치는 메모리 오류, 라이브러리를 잘못 호출해서 생기는 문제는 별도 검증 필요
x86이나 ARM에서 glibc를 동적으로 연결하는 환경까지 보장하려면 별도 검증 필요
증명 과정에서 확인한 사례
약 20MB의 특수한 입력에서 카운터 값이 범위를 벗어나 잘못된 메모리에 데이터를 쓰는 압축 해제기 오류 발견
64MB 입력과 2GB가 넘는 메모리가 필요한 이미지 디코더 오류, 파일 로드 제한이 적용되지 않는 논리 오류도 확인
cpp-httplib에서는 내부 트리 구조의 깊이를 따져,std::set소멸자의 재귀 호출로 스택 오버플로가 나지 않는다는 점까지 증명
증명에 드는 토큰 줄이기
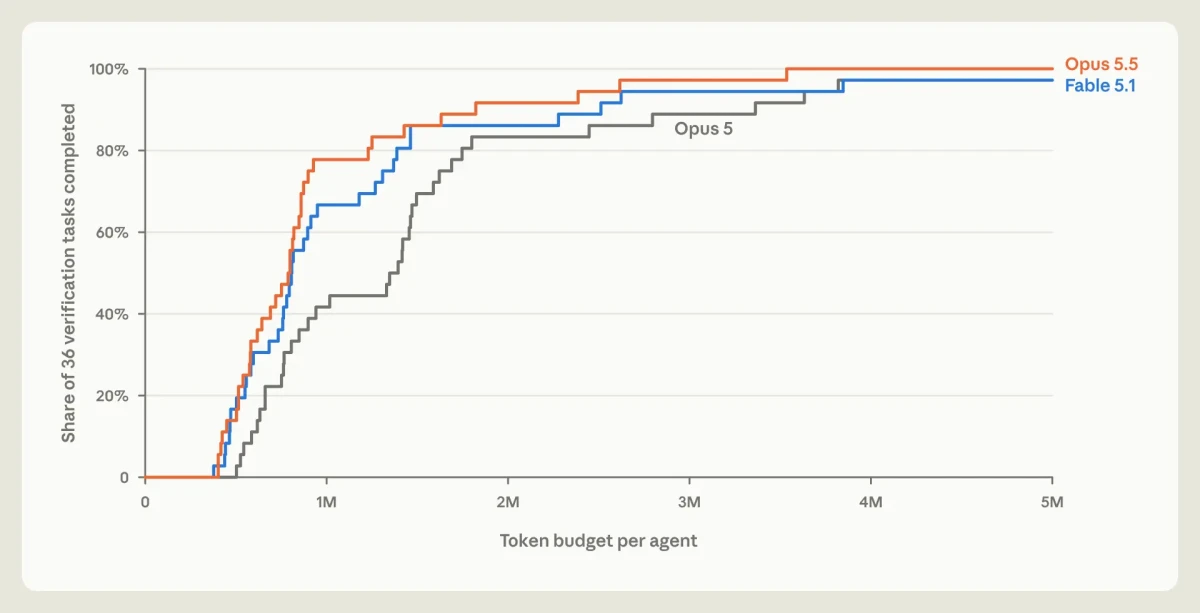
OSS-Fuzz에서 만든 검증 과제 36개로 비교
절반을 증명하는 데 Opus 5.5가 Opus 5보다 약 40% 적은 토큰 사용
그래프는 에이전트별 토큰 예산에 따른 과제 완료 비율로, 높을수록 좋음
대규모 증명에는 수억 토큰이 들 수 있어 비용 절감이 여전히 과제
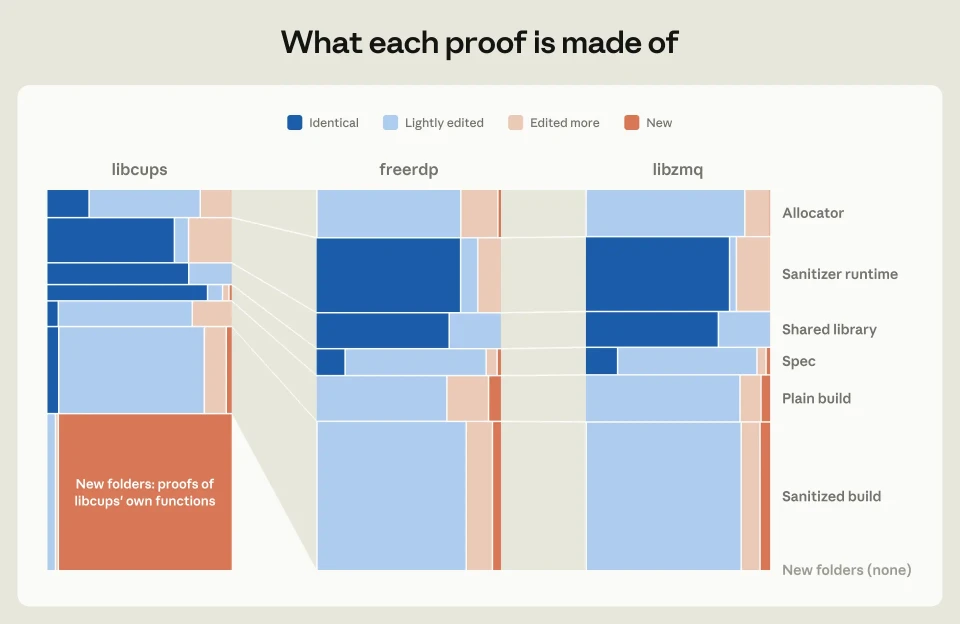
다른 에이전트가 작성한 증명을 복사할 수 있게 하자 단독 작업보다 17% 적은 토큰 사용
C 런타임 초기화나 AddressSanitizer처럼 여러 프로그램이 공유하는 코드의 증명을 재사용할 수 있기 때문
일부 증명과 RISC-V 및 Linux 동작 모델 공개
아직 고치지 않은 버그가 드러날 수 있는 증명은 제외함
source https://www.anthropic.com/research/formal-verification
HN에서는 퍼징으로 버그를 찾아 고친 뒤, 수학적 증명까지 하는 데 어떤 이점이 있느냐는 질문이 나왔다. 답글에서는 이번 연구가 64MB 미만의 모든 입력에서 프로그램이 비정상 종료하지 않는다는 점을 증명했다고 짚었다. 퍼징으로 하나씩 실행해 보지 못한 입력까지 검증할 수 있다는 점이 핵심이었다.
SIMD나 CUDA로 최적화한 코드에 원래 구현과 똑같이 동작한다는 Rocq 증명을 붙여, PR을 안심하고 병합하고 있다는 경험도 나왔다. 이 개발자는 컴파일 중간 단계인 LLVM IR을 기준으로 SIMD 코드를 검증하는 데 성과를 얻었지만, 동시성을 다루는 프로그램의 증명은 훨씬 더디게 진행됐다고 했다.
검사 기준 자체가 잘못되면 어떻게 하느냐는 우려도 있었다. 코드가 정해진 조건을 지켜도, 그 조건이 원래 만들려던 기능을 제대로 설명하는지는 별도로 확인해야 한다는 것이다. 다른 댓글은 메모리 처리 같은 구현 실수를 줄이고 요구사항과 설계 문제에 집중할 수 있다는 점에 의미를 뒀다.
증명 코드가 너무 길어져 더 복잡한 프로그램에서는 한계에 부딪힐 수 있다는 지적도 나왔다. 이에 증명도 일반 코드처럼 공통 부분을 나누고 재사용하기 쉽게 작성해야 한다는 의견이 이어졌다. 이런 능력이 좋아지면 AI의 코딩 능력도 함께 나아질 수 있다는 전망이다.
