Claude Fable 5.1과 Claude Mythos 5.1
Claude Fable 5.1과 Claude Mythos 5.1 출시
코딩과 지식 작업을 위한 최첨단 모델
Claude Fable 5.1은 복잡하고 장시간 실행되는 작업에 강하며, 연구 역량을 통해 AI 모델이 과학 발전에 기여할 가능성을 보여줌
제공 범위는 모델별로 다름
Claude Fable 5.1은 오늘부터 모든 환경에서 이용 가능
사이버 방어 전문가와 생명과학자를 위한 Claude Mythos 5.1은 신뢰 기반 액세스 프로그램을 통해 제공됨
벤치마크 성능 향상
Terminal-Bench-Science 0.1에서 52.6%를 기록해 Fable 5보다 2배 넘게 높아짐
Terminal-Bench 4.0에서는 Fable 5의 42.0%보다 높은 55.8%를 달성
Fable 5보다 훨씬 높은 성능을 낼 수 있으며, 낮은 effort level로 설정하면 훨씬 적은 비용으로도 비슷하거나 더 나은 결과를 얻을 수 있음
캐시 읽기 비용 절감
Fable 5.1의 cache read 비용은 Fable 5보다 75% 낮아짐
100만 토큰당 $0.25로 책정
실제 2026년 8월 4주 사용량 기준 일반 워크로드 비용 약 25%
컨텍스트·도구 사용량이 많은 고도 에이전트 워크로드는 최대 약 45% 줄어듦
나머지 요금은 Fable 5와 동일한 입력 100만 토큰당 $10, 출력 100만 토큰당 $50임
실제 모델 사용 비용은 일반적인 워크로드에서 약 25%, 에이전트 활용도가 높은 워크로드에서는 최대 45% 줄어듦
안전장치의 오탐과 fallback 감소
사이버보안 안전장치가 무해한 요청을 잘못 표시하는 빈도를 약 60% 낮춤
기본적인 생물학·의학 질문에서는 최근 fallback 비율을 약 85% 줄였음
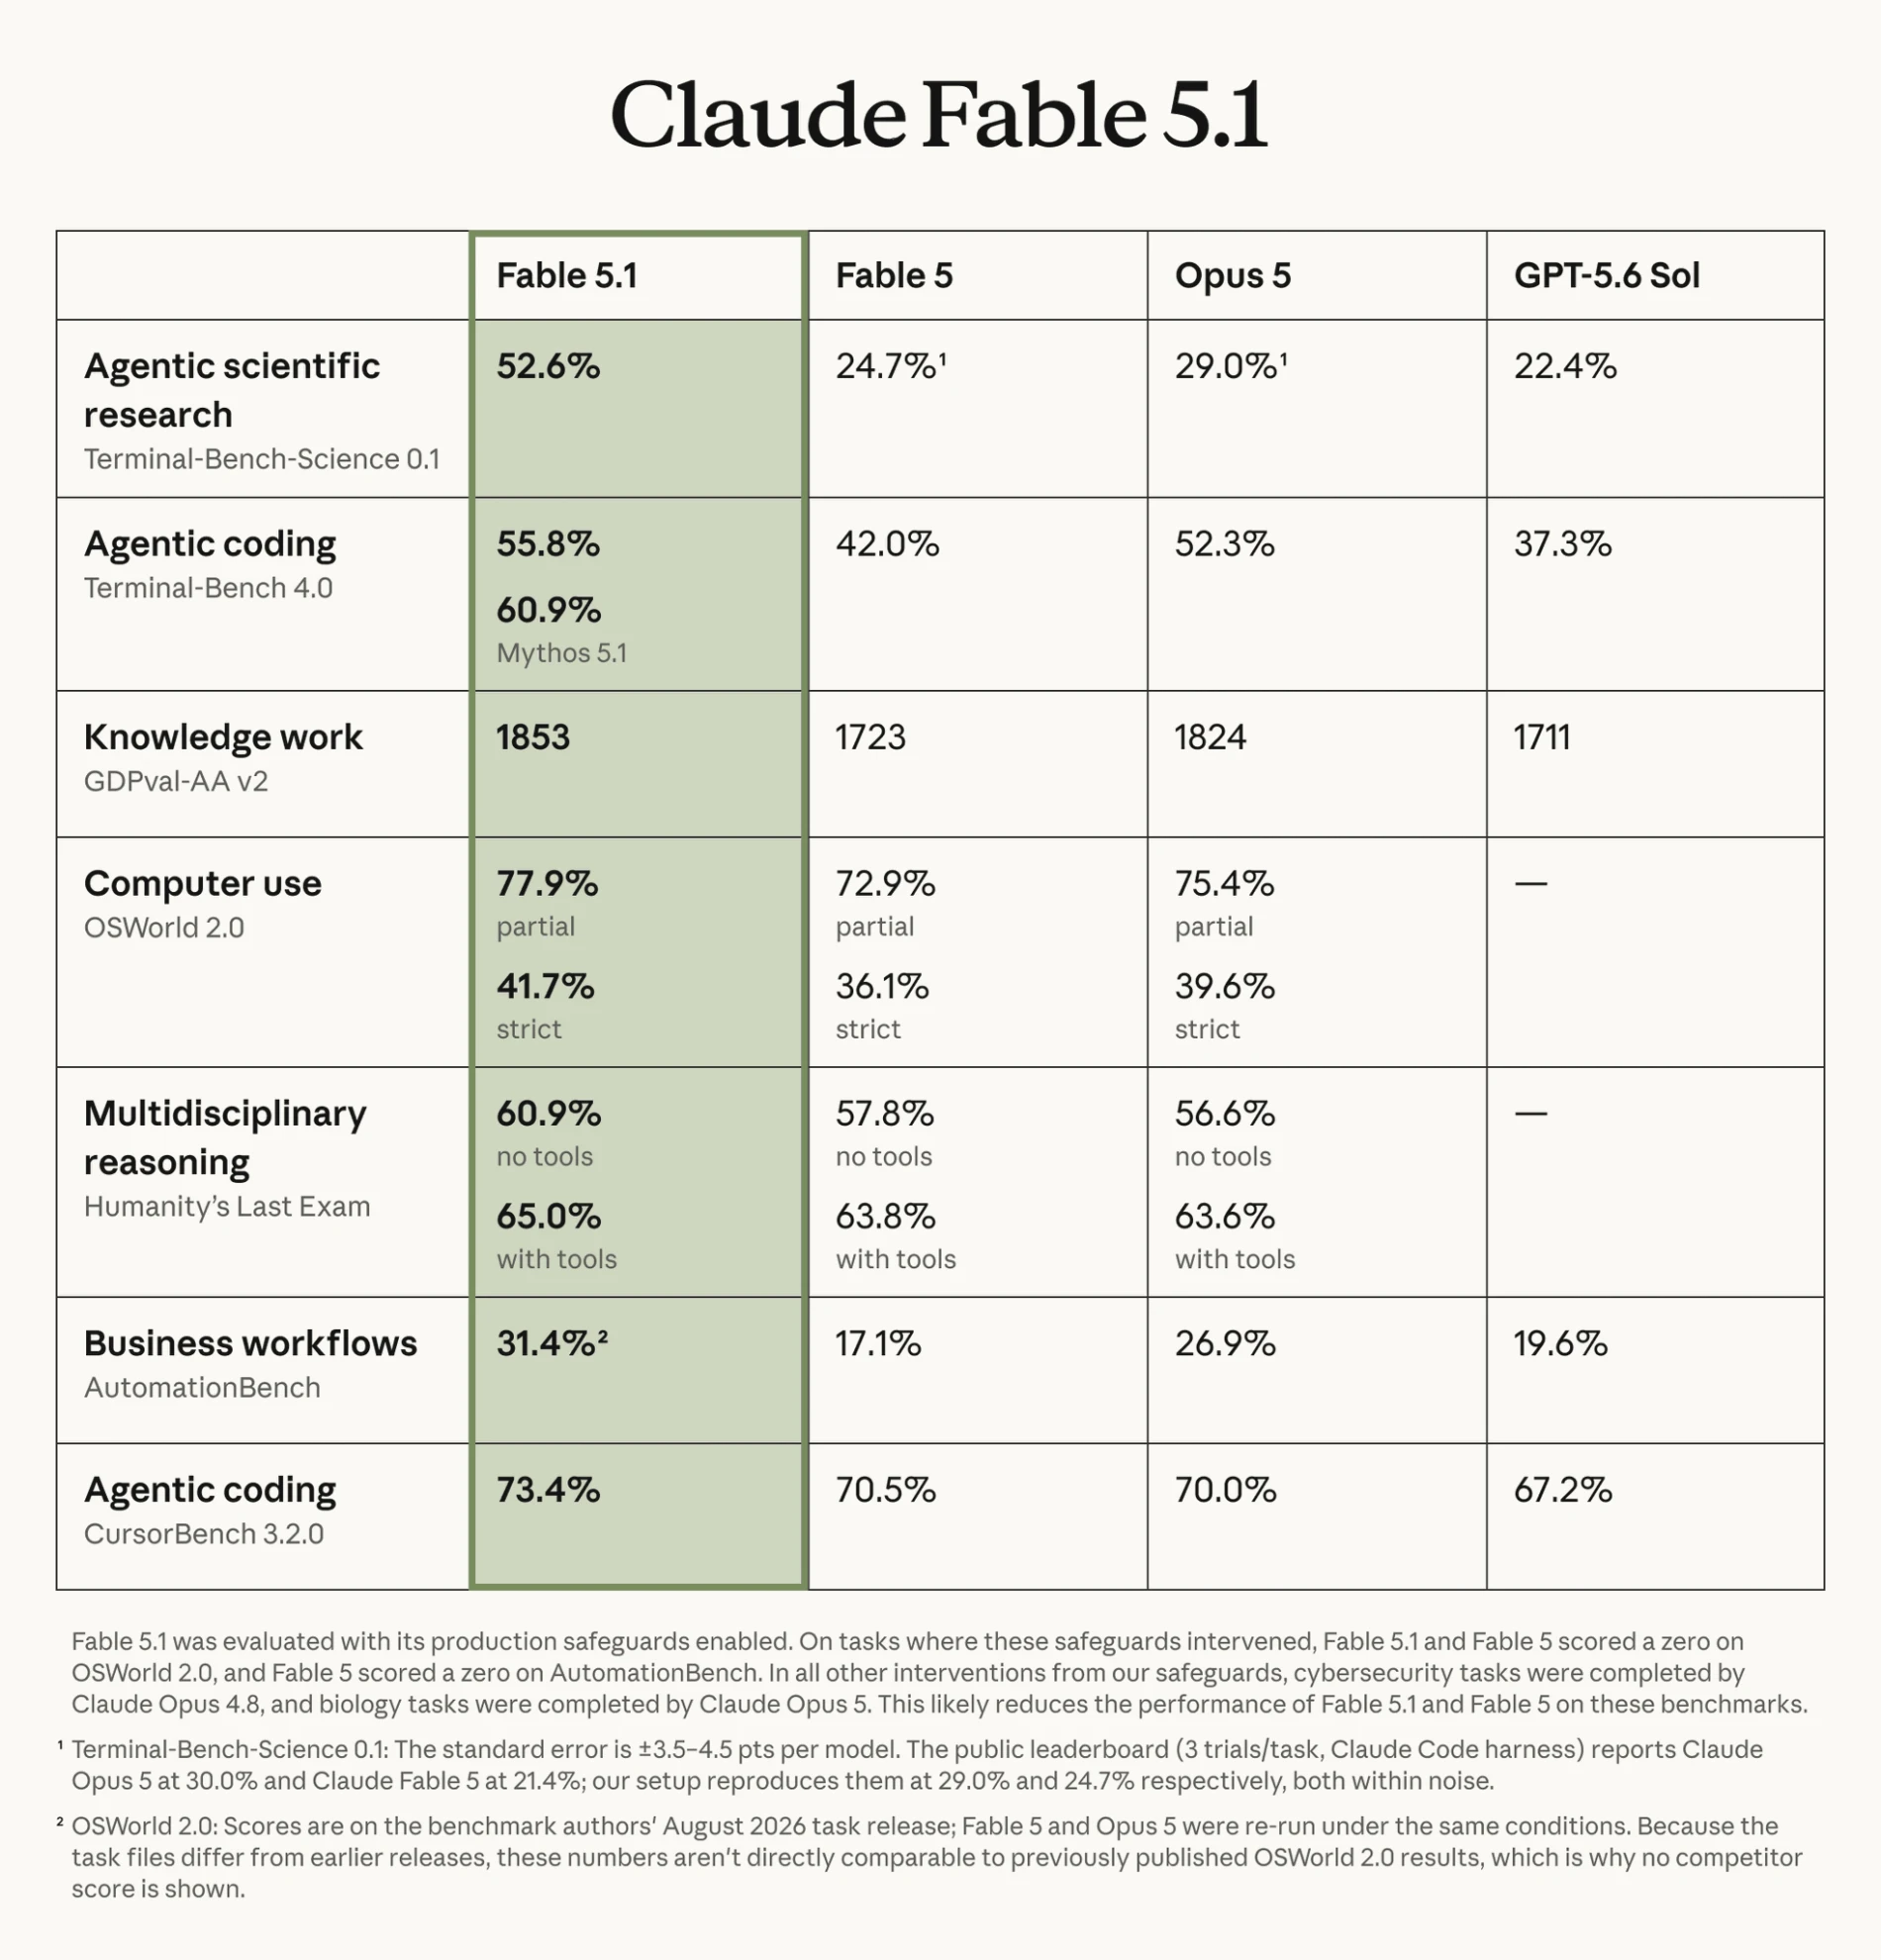
source https://www.anthropic.com/claude-fable-and-mythos-5-1
HN에서는 새 모델의 벤치마크보다 실제 작업을 끝까지 맡길 수 있는지가 더 중요한 판단 기준으로 떠올랐다. 복잡한 코드의 맥락을 파악하고 설계에서 놓친 부분까지 찾아냈다는 경험은 기대를 높였다. 그러나 과학 분야 점수를 빼면 이전 모델보다 나아진 폭이 크지 않다는 지적도 있다. 이미 저렴한 모델로 충분한 작업이라면 높은 비용을 감수할 이유가 뚜렷하지 않다는 것이다.
글쓰기 개선도 자연스러움과 간결함을 구분해 봐야 한다. 상투적인 표현이 줄고 문체 지시를 잘 따른다는 평가가 있었지만, 문장이 길고 빽빽해 읽기 어렵다는 반응도 이어졌다. 간단한 UI 문구를 다듬으라고 했더니 오히려 과장되고 부자연스러운 표현을 제안했다는 사례도 나왔다. 문장이 전보다 자연스러워졌다고 해서 짧고 정확해진 것은 아니라는 뜻이다.
실무자들이 특히 민감하게 본 부분은 비용의 예측 가능성이다. 캐시 읽기 가격 인하는 긴 대화 기록을 반복해서 참조하는 에이전트 작업에 유리하다. 반면 한 세션에서 구독 한도를 빠르게 소진하거나, 작은 수정에도 파일 전체를 다시 쓰고 같은 문제를 되풀이하며 토큰을 낭비했다는 경험도 있다. 표시된 할인율보다 작업 한 건을 마치는 데 드는 총비용과 완료율을 따져야 한다.
