성가신 크롤러들 (kernel.org)
AI 크롤러가 지속적인 시스템 부하를 일으키며 git.kernel.org 용량의 상당 부분을 점유하고 있음
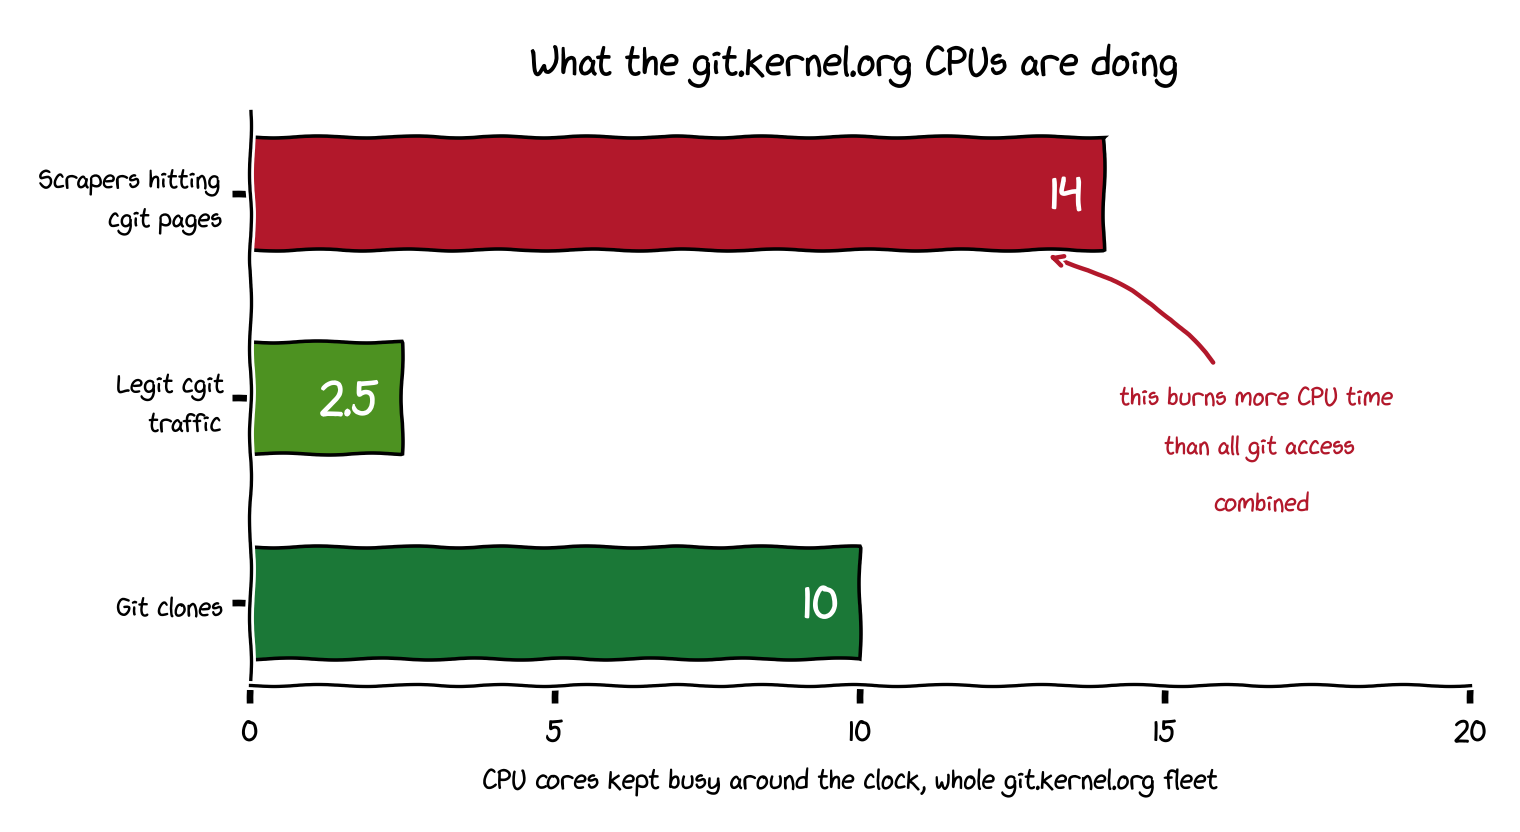
스크레이퍼용 커밋 렌더링에 쓰는 CPU 사이클이 git clone을 포함한 모든 정상 접근의 합보다 많음
지리적으로 분산된 5개 노드에서 어느 순간이든 CPU 코어 14개가 Git 커밋을 HTML로 렌더링하는 데만 쓰이는 상태임
git.kernel.org가 크롤러에 매력적인 이유
Linux 개발 기록은 공개돼 있고 AI 이전의 순수한 학습 데이터를 쉽게 확보할 수 있어 LLM 학습용으로 가치가 큼
복제 가능한 Git 저장소와 실시간으로 볼 수 있는 토론 아카이브에 전체 커널 개발 역사가 담겨 있음
LLM이 생성한 콘텐츠로 다시 LLM을 학습시키면 디지털 프리온 질환에 해당하는 문제가 생기므로, LLM 콘텐츠가 없다고 보장되는 커널 커밋 전체 역사는 특히 귀중한 데이터가 됨
가장 비효율적인 수집 방식
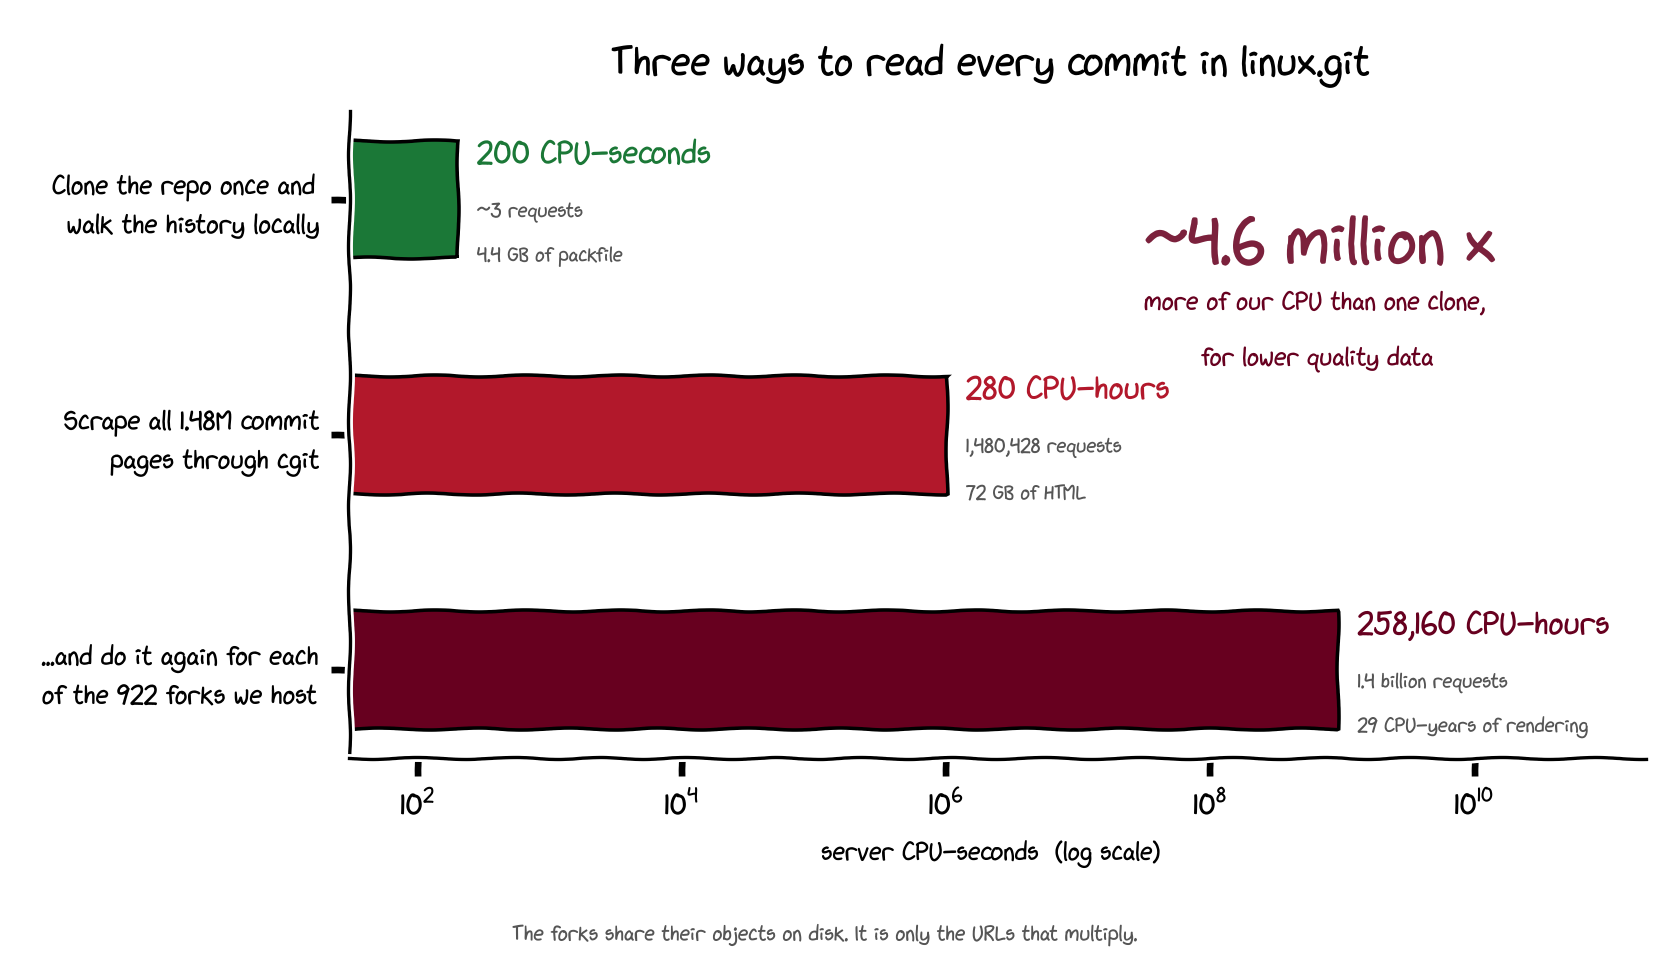
저장소와 아카이브 전체를 git clone으로 제공하지만, 크롤러는 커밋마다 HTML을 생성해 파싱하는 가장 비효율적인 방법을 택함
LKML 전체도 Git 저장소로 복제해 원하는 방식으로 처리할 수 있으므로, 저장소를 한 번 clone한 뒤 모든 커밋을 순회하면 끝남
linux.git의 방대한 포크와 cgit 기능이 수십억 개의 유효한 크롤링 URL을 만들어 중복 렌더링을 증폭함
작성 시점의 linux.git에는 약 148만 개 커밋이 있고 git.kernel.org에는 포크가 약 922개 존재함
백엔드에서는 각 포크가 대부분 같은 객체를 공유하므로 매우 효율적임
스크레이퍼에는 같은 148만 개 커밋의 중복본 922개로 이어지는 수십억 개의 유효한 URL이 생기며, 실제로 이를 모두 긁고 있음
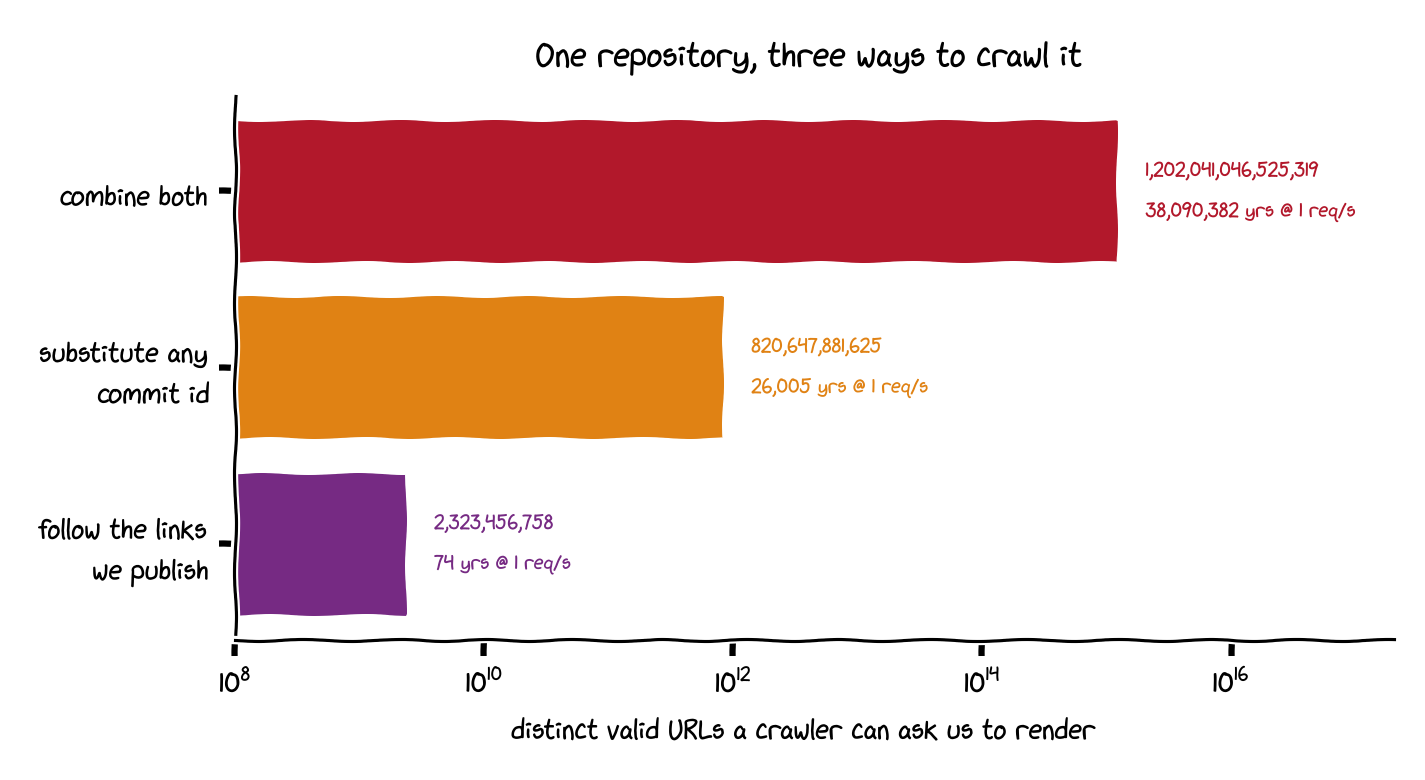
cgit은 커밋뿐 아니라 패치, plain 렌더링, 임의 커밋 간 diff도 제공함
사람이 이용하거나 robots.txt를 따르는 크롤러가 쓰던 시절에는 적합했지만, 지금은 linux.git 포크 하나만으로도 과장해 말하면 1.2 METRIC BAJILLION개의 유효한 URL을 생성할 수 있음
차단이 더는 통하지 않는 과정
초기에는 로그에서 스크레이퍼 IP를 찾아 fail2ban으로 막을 수 있었지만, 봇이 식별 정보를 숨기며 차단 방식이 계속 무력화됨
처음에는 user-agent로 정체를 드러냈으나 이후 일반 브라우저로 위장하기 시작함
8년 된 방치된 Linux 포크의 모든 커밋을 가져가는 IP는 실제 Windows Chrome 사용자가 아니라고 판단해 IP를 차단함
봇이 전체 서브넷으로 분산됐을 때도 Google Compute에서 Firefox로 위장하는 접근처럼 명백한 경우에는 ASN 전체를 막을 수 있었음
이 과정에서 커밋 링크 검사를 자동화하던 정상 인스턴스가 간혹 함께 차단됨
이후 크롤러가 수백만 개의 주거용·모바일 IP로 분산되면서 IP 차단은 사실상 쓸모없어짐
각 IP는 최신 브라우저로 위장해 4~5번만 요청한 뒤 다시 나타나지 않아, 봇임을 확인할 때는 이미 수집을 끝낸 상태였음
재방문하지 않을 IP를 방화벽 규칙에 추가하면 규칙 집합만 불필요하게 커짐
메뚜기 떼처럼 몰려와 시스템이 쓰러질 때까지 짧고 강하게 공격한 뒤 다른 대상으로 이동하고, 복구되면 다시 돌아오는 패턴이 반복됨
이런 접근은 지금도 이어지며, 이른바 ‘proxy SDK monetization’이라는 큰 사업을 통해 가정의 TV까지 프록시로 동원될 수 있음
작업증명 도입과 한계
약 1년 전 Anubis를 모든 접근 앞에 배치해 요청자가 일회성 계산 비용을 부담하도록 함
요청자 자신의 IP와 제공된 비밀값을 문자열에 결합했을 때 앞자리가 0 네 개인 sha256 해시를 만드는 문자열을 찾게 하는 방식이었음
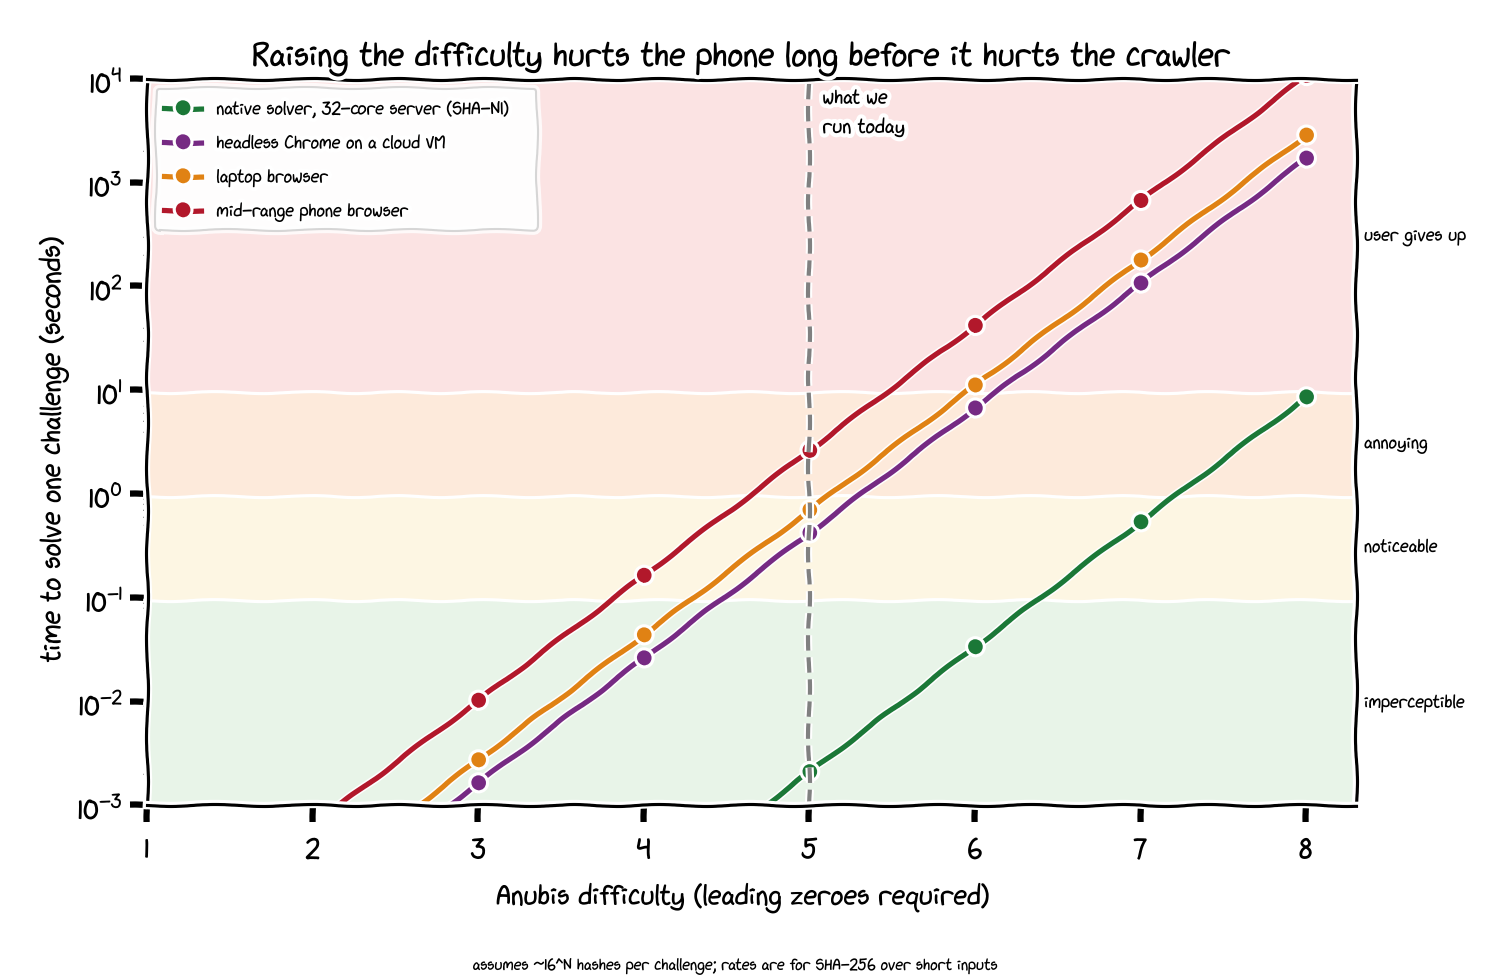
Anubis는 처음에는 즉시 효과를 냈지만, 봇이 난이도 4와 5를 차례로 풀면서 몇 달씩만 시간을 벌어줌
초기 몇 달간 봇은 경계에서 차단되자 더 쉬운 대상으로 이동했고, 사용자는 약간 불편해도 감수했으며 배포도 어렵지 않았음
봇이 난이도 4를 풀기 시작해 5로 높이자 정상 사용자의 불편이 커짐
모바일 기기에서는 풀이에 몇 초가 걸리고 연산 중 휴대전화가 불편할 만큼 뜨거워졌지만, 다시 몇 달간 크롤러를 억제할 수 있었음
결국 봇도 난이도 5를 풀기 시작함
현재 트래픽과 시스템 영향
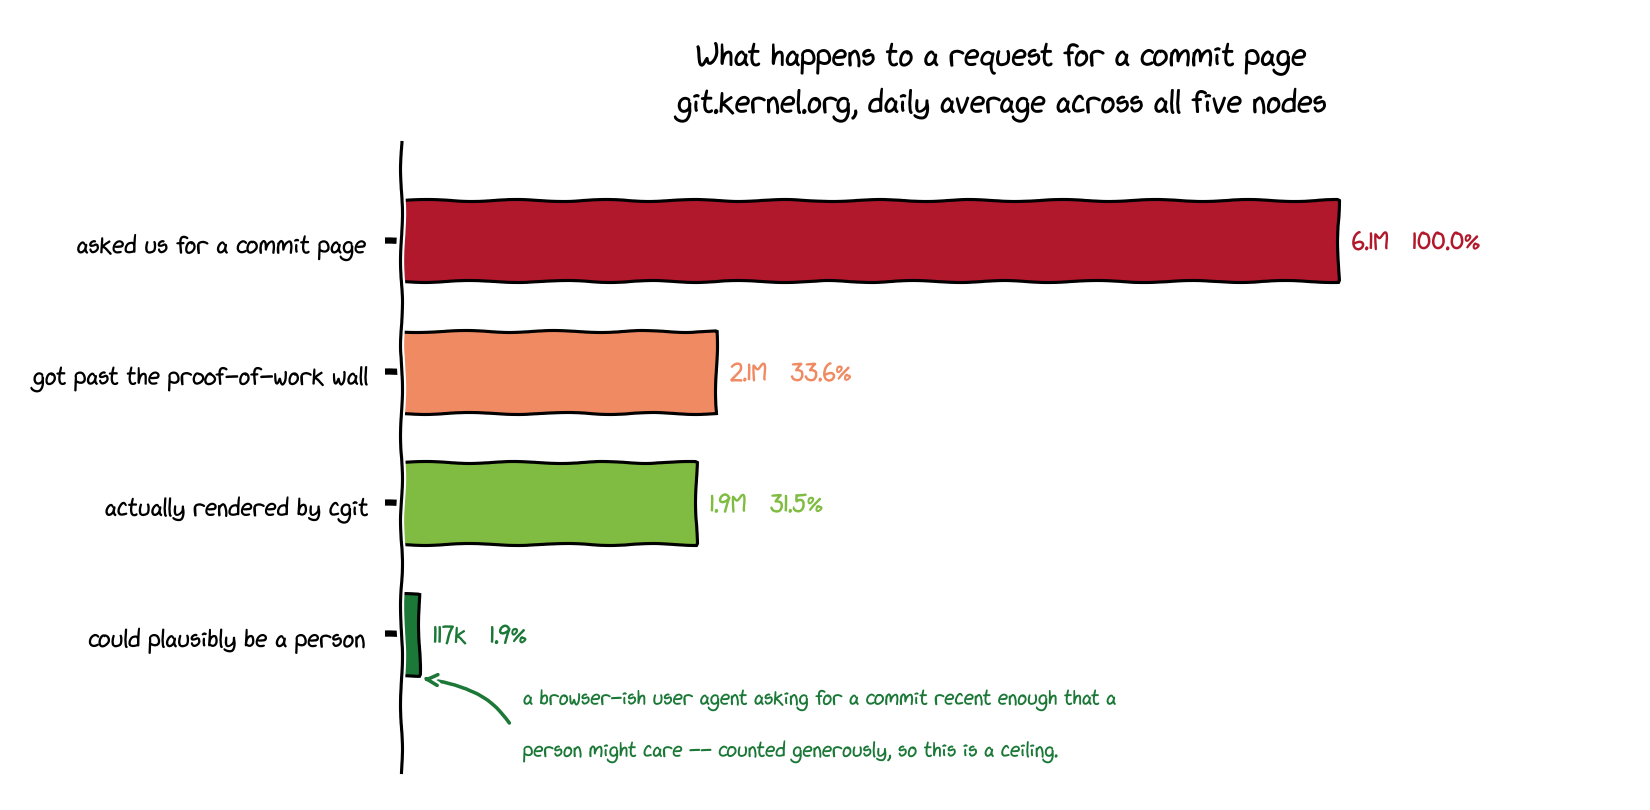
현재 git.kernel.org에는 무작위 커밋을 보려는 요청이 하루 약 600만 건 들어오며, 정상 요청은 넉넉하게 추정해도 전체의 약 2%뿐임
66%는 Anubis challenge에서 즉시 차단되지만 33%는 계산을 풀고 메인 사이트에 도달함
통과한 요청이 봇인지 사람인지 확정할 수는 없으나, 오래된 임의 포크의 과거 커밋을 요구한다면 실제 개발자일 가능성은 낮음
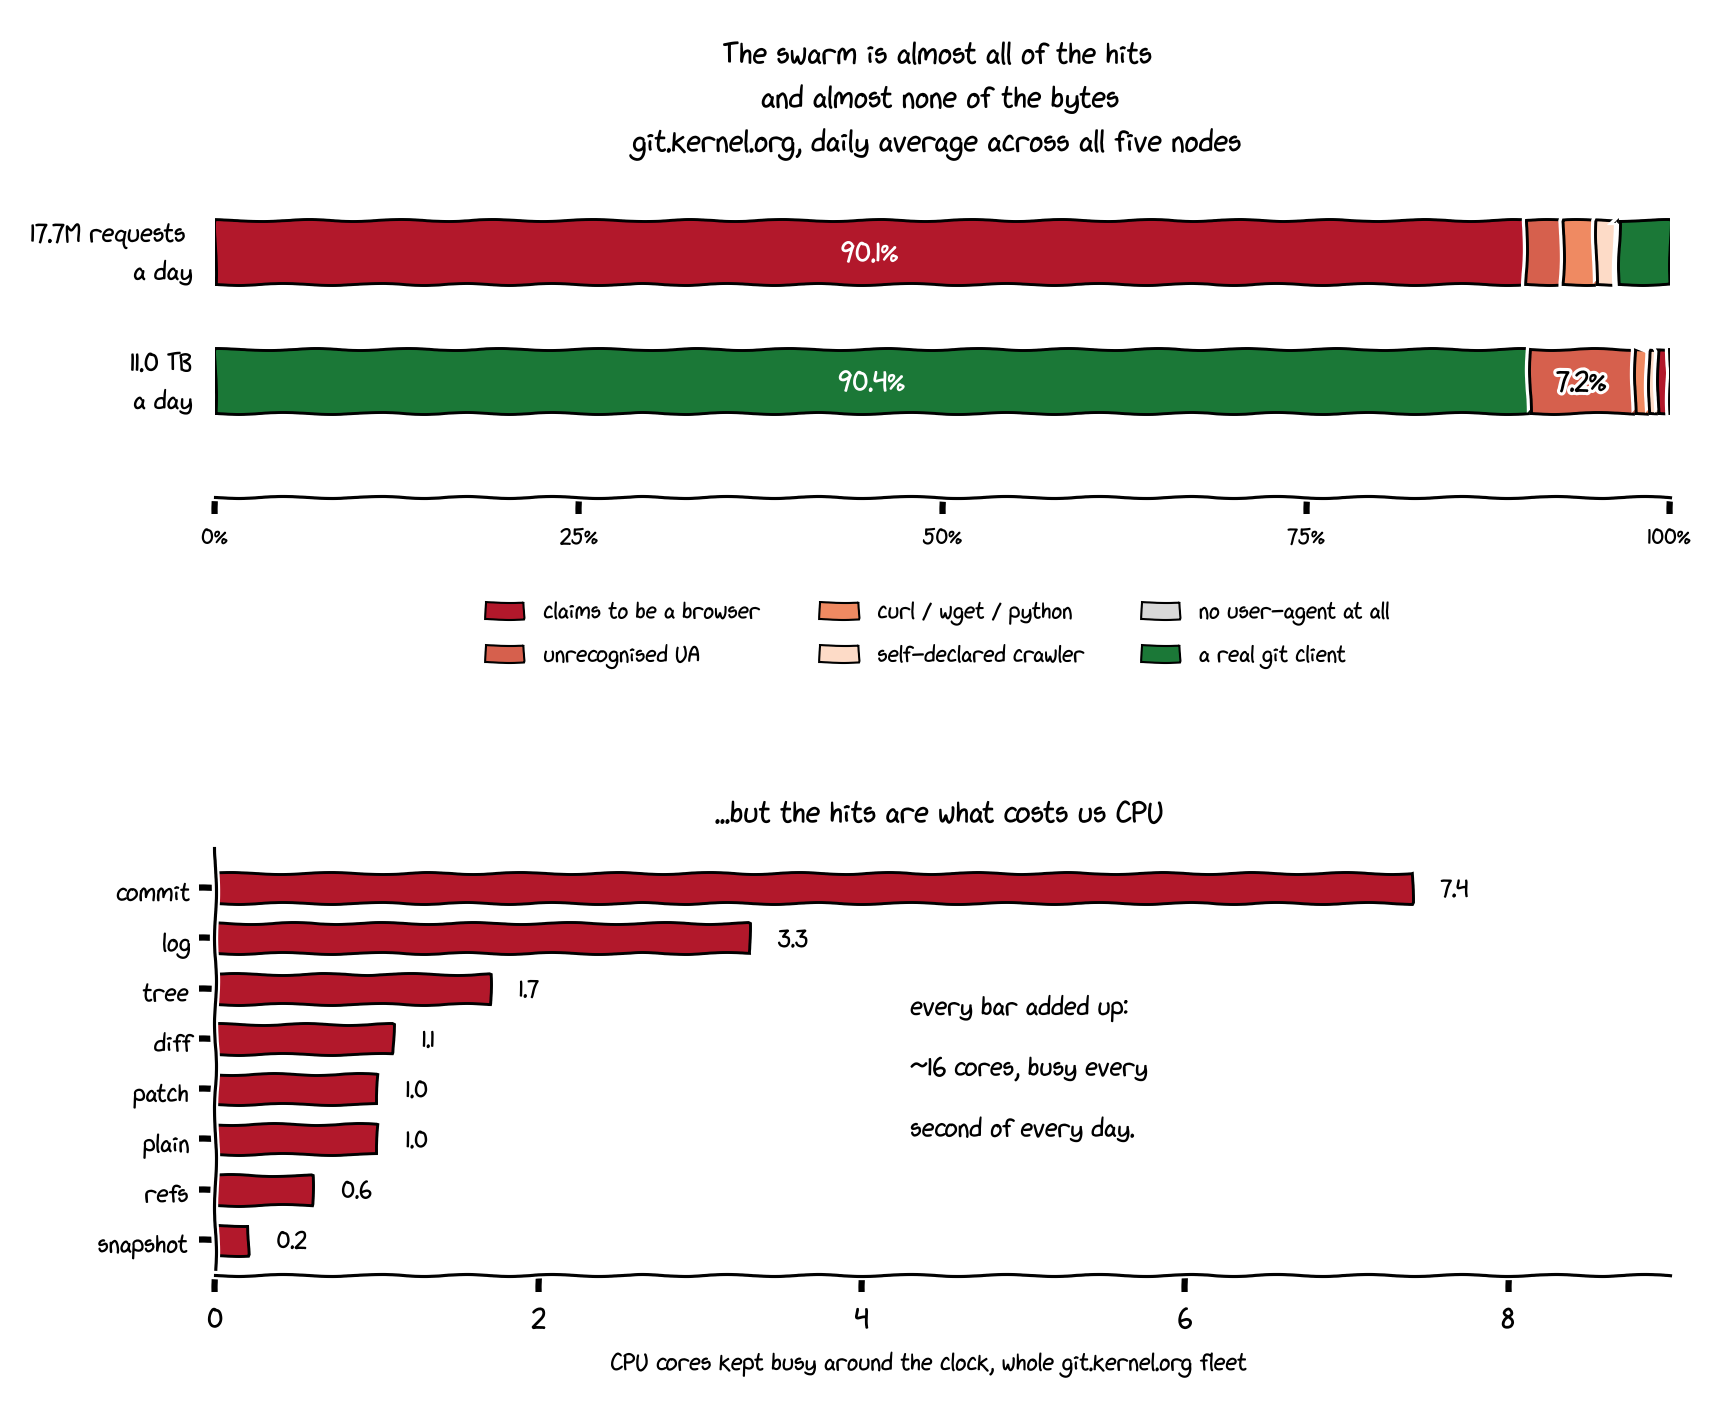
서비스는 아직 완전히 압도되지 않았지만, 스크레이퍼가 평균적으로 전체 CPU 용량의 20%를 계속 사용함
지리적으로 분산된 5개 노드의 총 90개 코어 가운데 14~16개가 스크레이퍼용 커밋 렌더링에 상시 묶여 있음
부하는 평평한 20%가 아니라 크롤러 떼가 파도처럼 몰려올 때 급격히 치솟는 형태임
git.kernel.org는 대체로 빠르게 응답하며, 실제 장애는 스크레이퍼보다 20개 노드에서 stable.git을 동시에 shallow clone하는 식으로 설계가 부실한 CI 시스템 때문에 더 자주 발생함
shallow clone은 부담이 크므로 이런 사용 방식이라면 자체 미러를 운영해야 함
기능 축소와 앞으로의 대응
단순한 해결책이 없어 크롤링 가능한 URL과 비싼 작업을 줄이기 위해 기능을 끄고 익명 접근을 제한하고 있음
일부 기능은 사라질 예정이며, 특히 익명으로 리소스에 접근할 때 제한이 커질 수밖에 없음
AI 거품이 꺼져 모델 학습 주체가 줄거나, 이들이 더 효율적인 방식으로 데이터를 가져가기를 기대할 수 있지만 어느 쪽도 확실하지 않음
맞춤형 AI 모델 회사는 계속 생겨나 학습 데이터를 원하고, 앱 제작자는 수익화를 위해 가전제품을 공격 경로로 전환하는 방식을 이어갈 가능성이 큼
요청하는 누구에게나 모든 데이터를 다운로드할 수 있게 하겠다는 약속은 유지하지만, 앞으로는 더 많은 절차를 거쳐야 할 수 있음
미안함. (캐나다인이라면 의무적으로 해야 하는 말이기도 함)
source https://people.kernel.org/monsieuricon/creepy-crawlies
HN에서는 AI 크롤러의 과도한 요청만큼이나, 이를 막는 과정에서 실제 이용자의 접근성까지 훼손되는 상황을 심각하게 봤다. 작업증명은 모바일 기기에 긴 대기와 발열을 안기지만, 서버나 전용 하드웨어를 쓰는 수집자에게는 큰 장벽이 되지 않는다. 요청마다 필요한 데이터를 얻는 크롤러에는 계산 비용을 높이는 것만으로 수집 동기를 꺾기 어렵다는 지적도 거듭됐다.
운영자들의 경험은 사이트 규모와 무관하게 비슷했다. 소규모 코드 저장소와 개인 사이트, 일반 소비자 서비스까지 깊은 경로와 계산 비용이 큰 기능을 반복 호출하는 트래픽에 시달렸다. 특히 cgit은 커밋과 파일, 임의 비교 조합마다 링크가 생겨 작은 저장소도 탐색할 주소가 급증한다. 범용 크롤러는 이런 구조나 서버 비용을 구분하지 않은 채 모든 링크를 따라가며, Git 복제나 구조화된 API처럼 효율적인 방법도 활용하지 않는 경우가 많다.
대응책으로는 오래된 커밋과 diff 같은 고비용 경로 제한, 비로그인 요청의 속도 제한, 정적 캐시, 클라이언트 렌더링 등이 제시됐다. 그러나 로그인과 인증을 강제하거나 HTML 화면을 닫으면 공개 자료를 누구나 읽을 수 있다는 원칙이 약해진다. IP와 사용자 에이전트 차단 역시 주소 교체와 주거용 프록시 앞에서는 오래 버티기 어렵다.
