GLM-5.3-Flash (ox-alpha) 출시
GLM-5 시리즈 최초의 네이티브 멀티모달 모델을 공개함
총 320B 파라미터 중 18B만 활성화하면서 벤치마크와 실제 워크로드에서 GLM-5.2를 앞섰고, 가격은 10분의 1 수준이며 코딩·에이전트 벤치마크에서는 Claude Opus 4.8에 근접함
sparse attention과 linear attention을 결합한 첫 하이브리드 구조로 정확한 long-context 역량을 유지하면서 서빙 비용을 크게 낮췄고, Manifold-Constrained Hyper-Connections(mHC)로 스케일링 효율도 높임
최신 30T-token 멀티모달 사전 학습 코퍼스를 함께 적용해 더 적은 연산으로 더 높은 지능을 내도록 설계함
출시 전
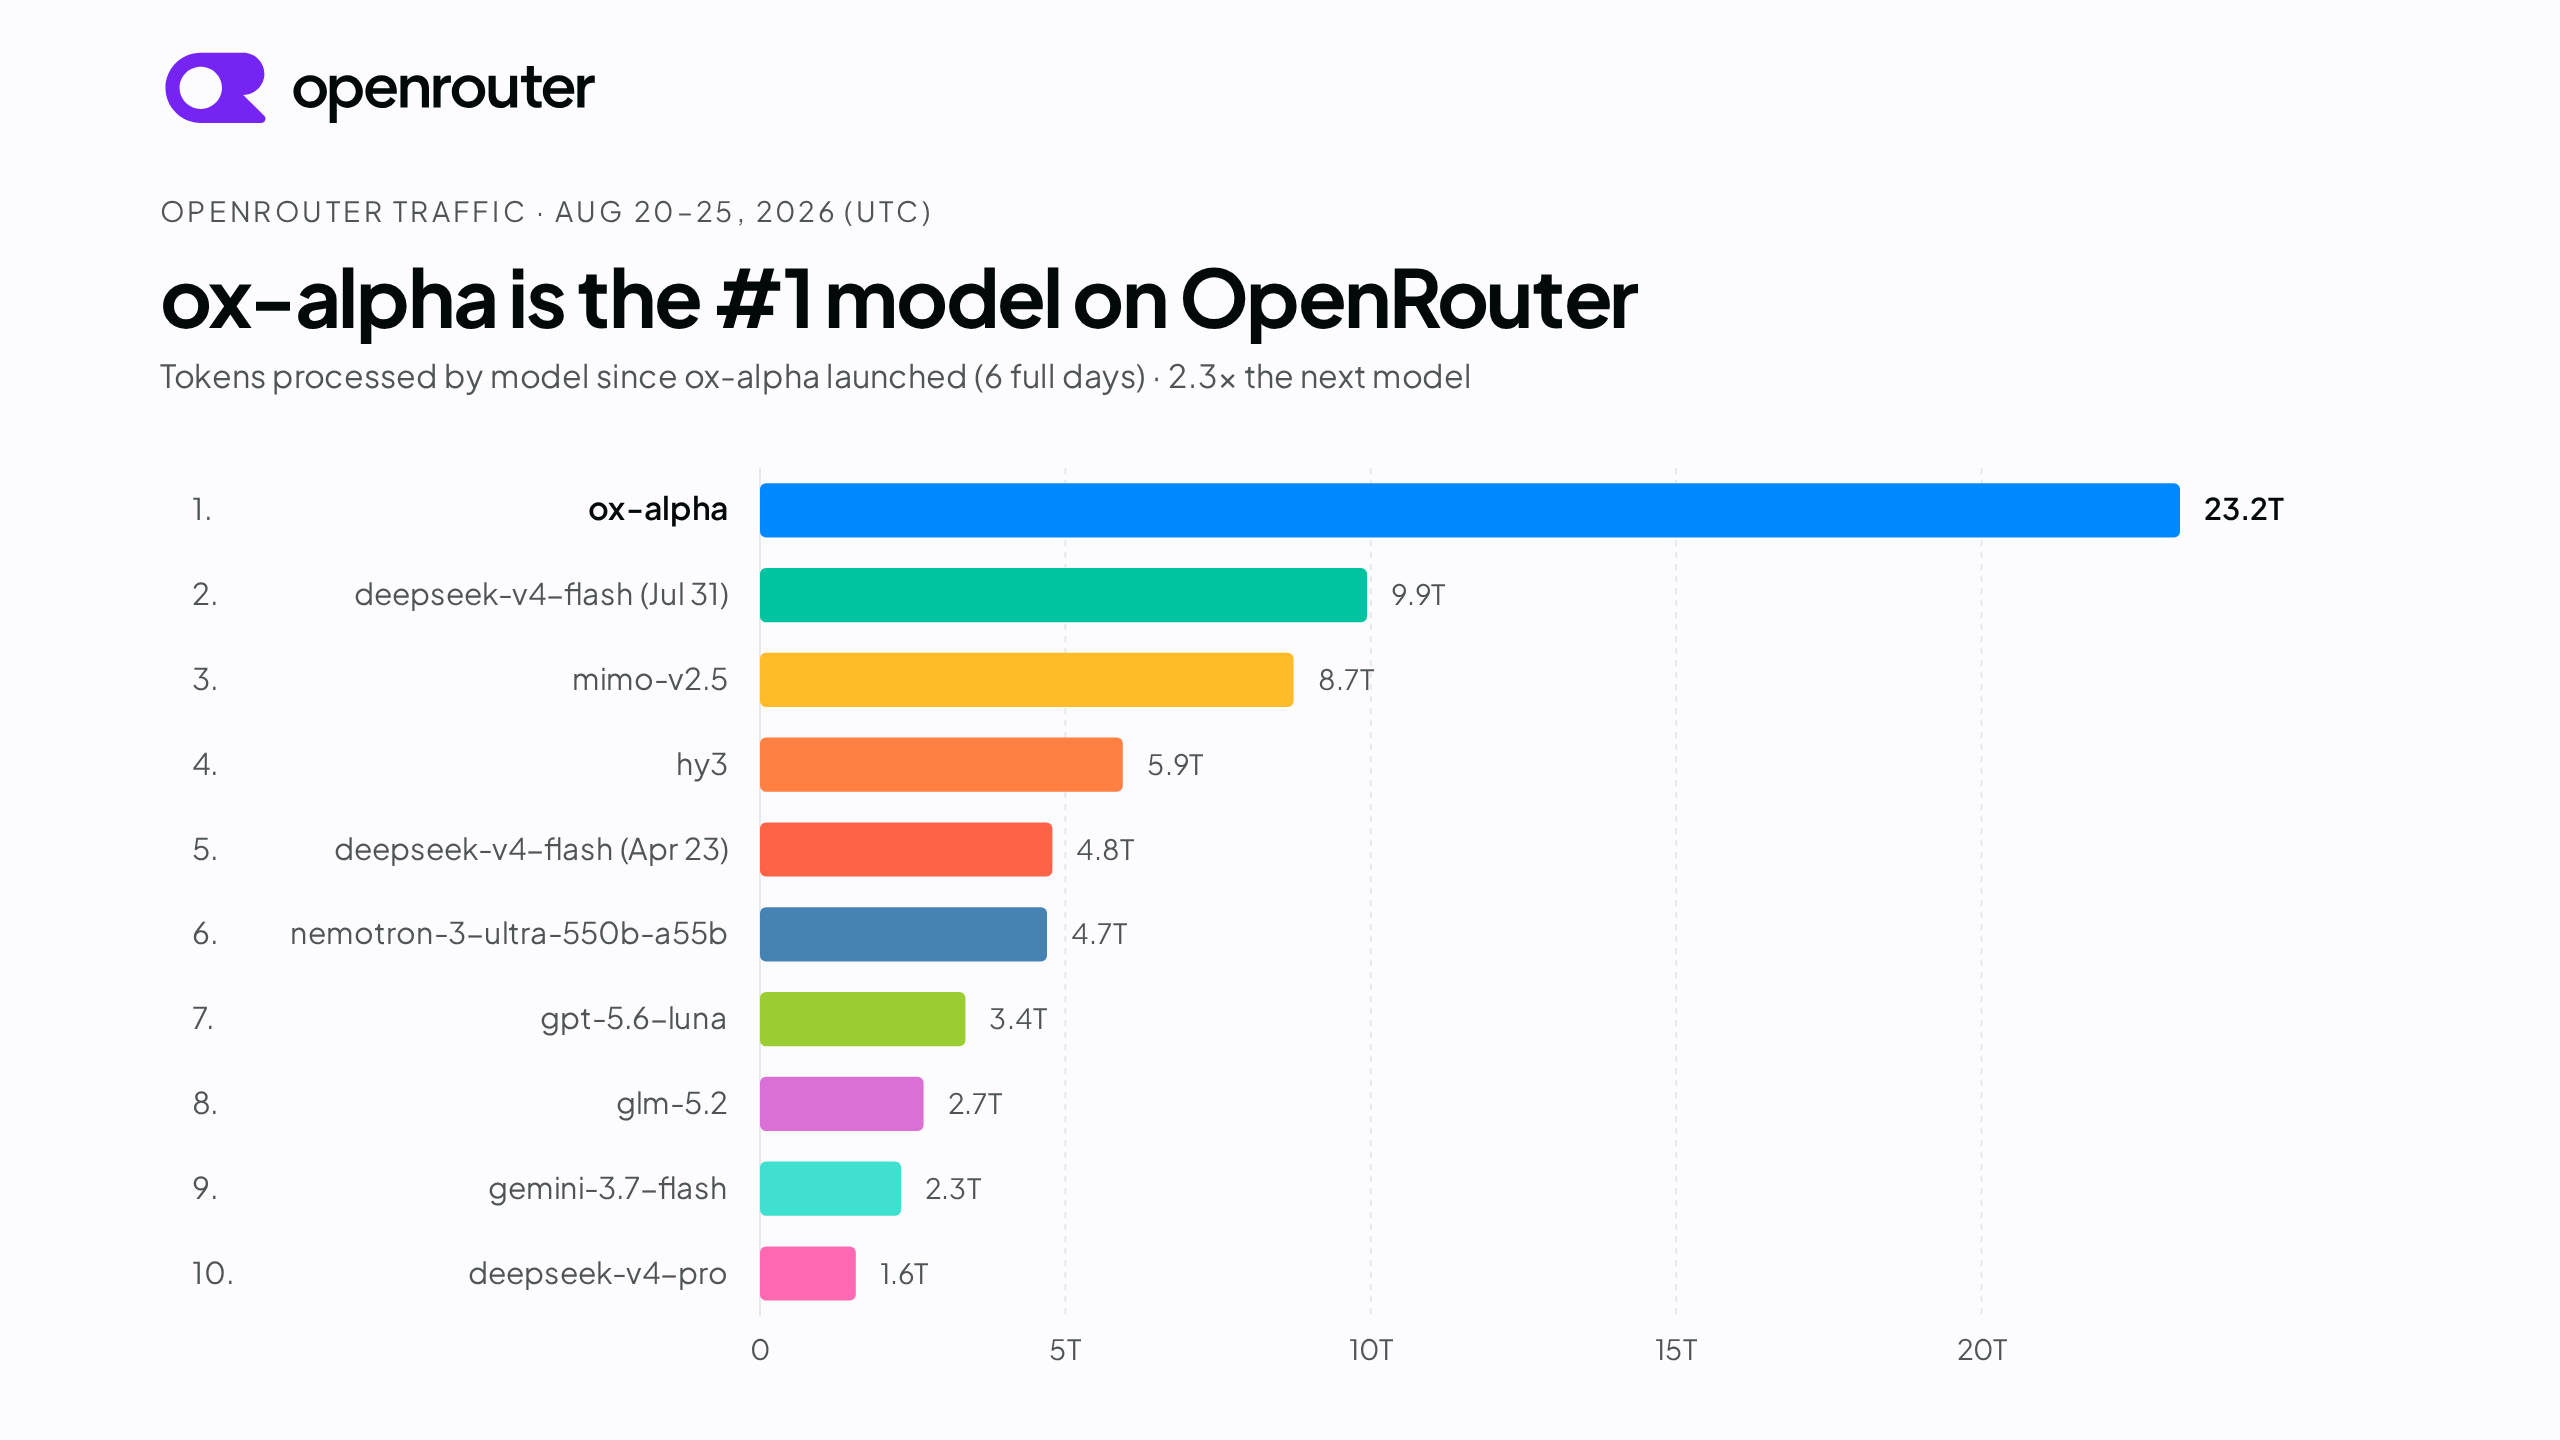
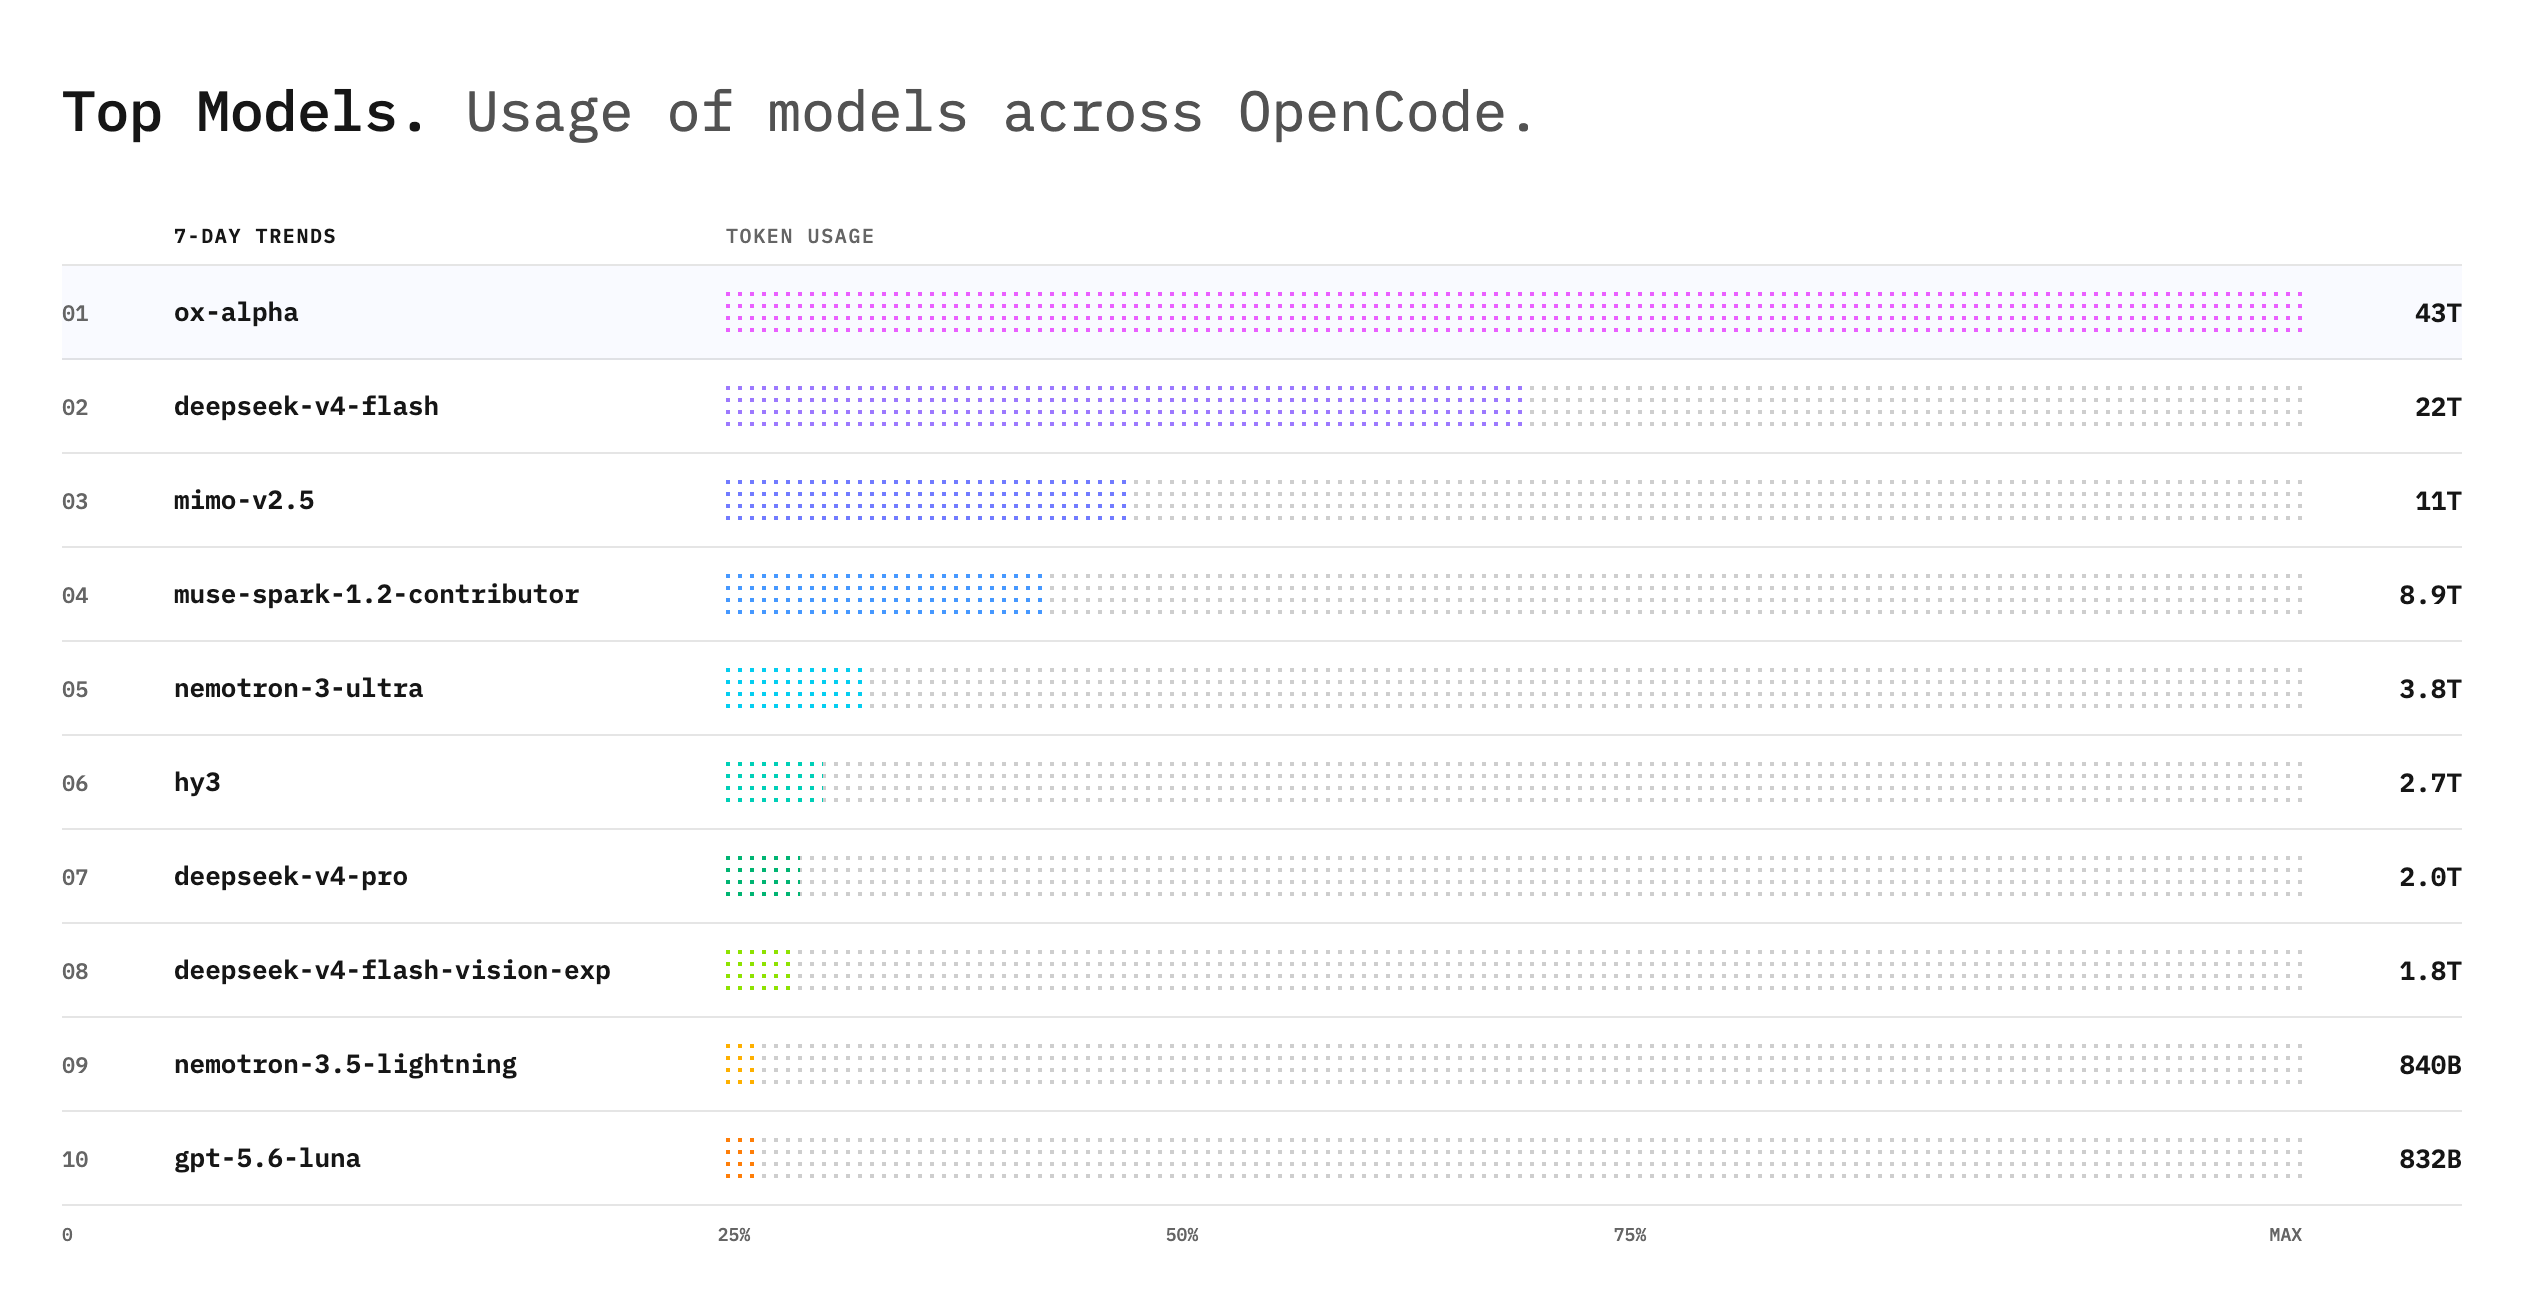
ox-alpha라는 익명 모델로 실사용 피드백을 수집함OpenCode와 OpenRouter에서 시험한 결과 빠르게 그 주의 최고 인기 모델이 됐으며, 이 트래픽은 모두 중국산 AI 칩으로 처리함
Flash 비용으로 확보한 경쟁력
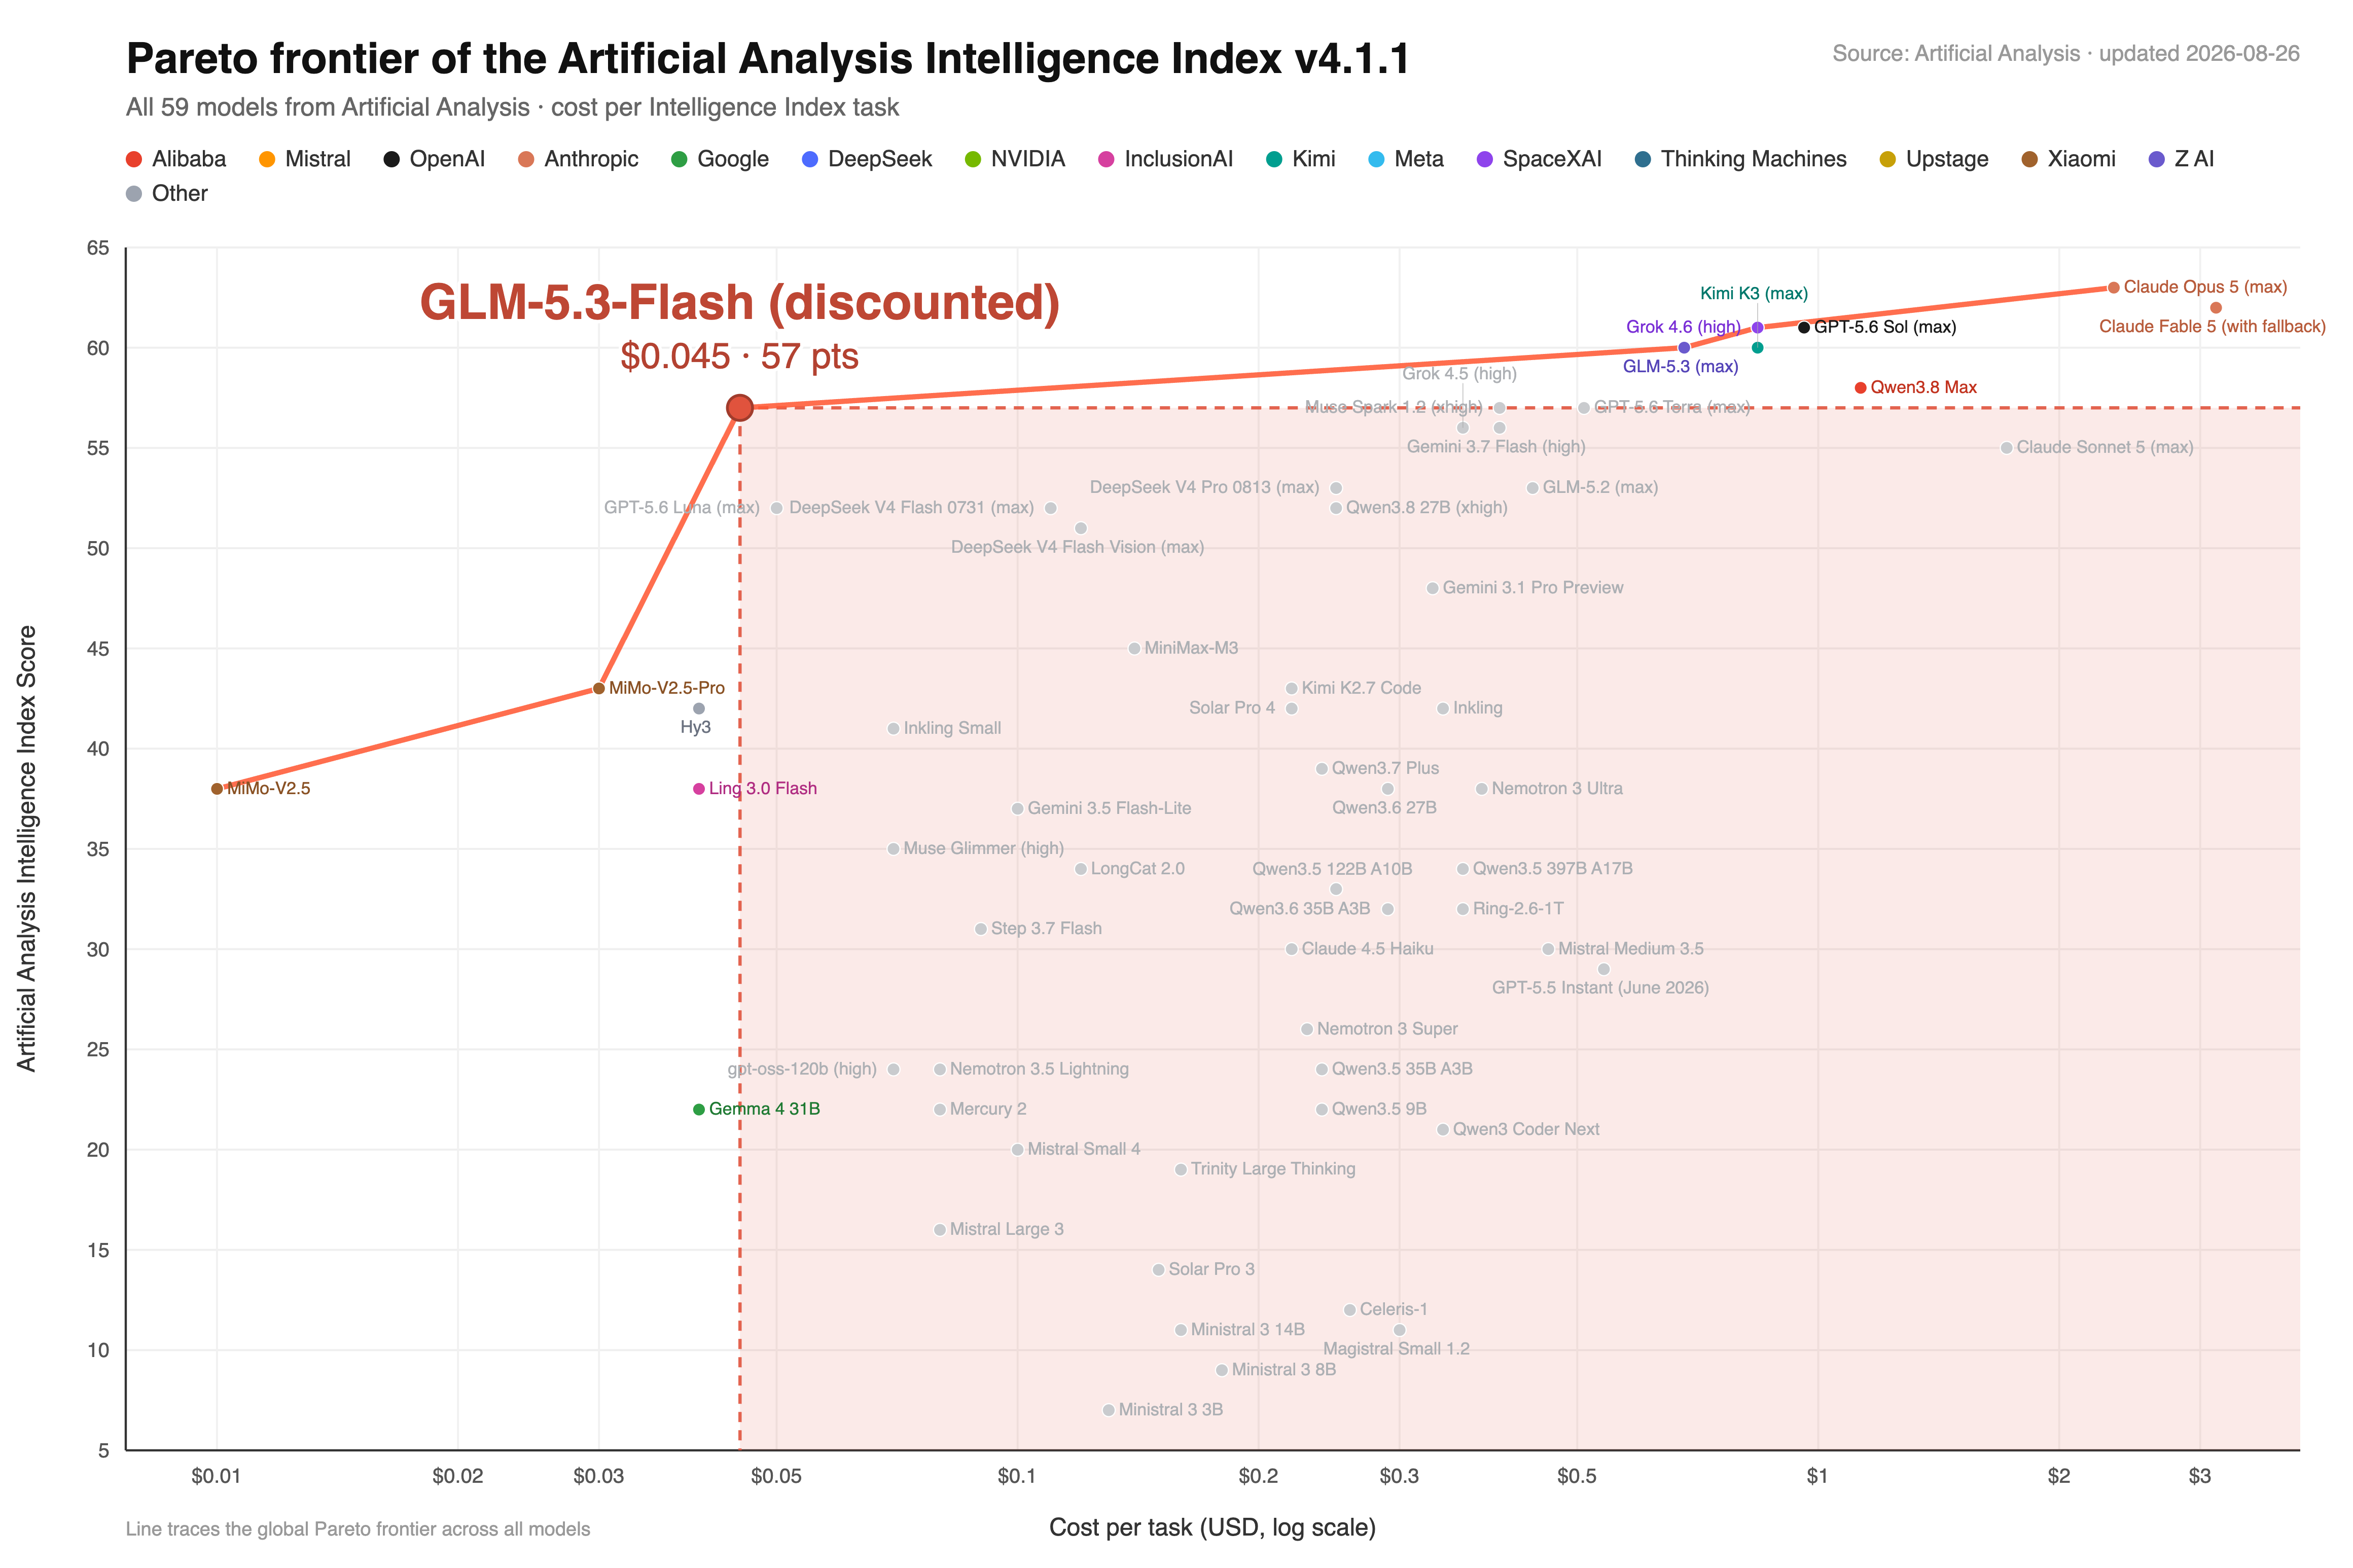
Artificial Analysis Intelligence Index v4.1.1에서 비용 대비 성능의 Pareto frontier를 확장함
할인 가격 기준 작업당 $0.045로 57점을 기록했으며, 이전에는 약 10배의 비용이 필요했던 지능 수준을 제공해 광범위한 워크로드의 기본 모델로 쓸 수 있음
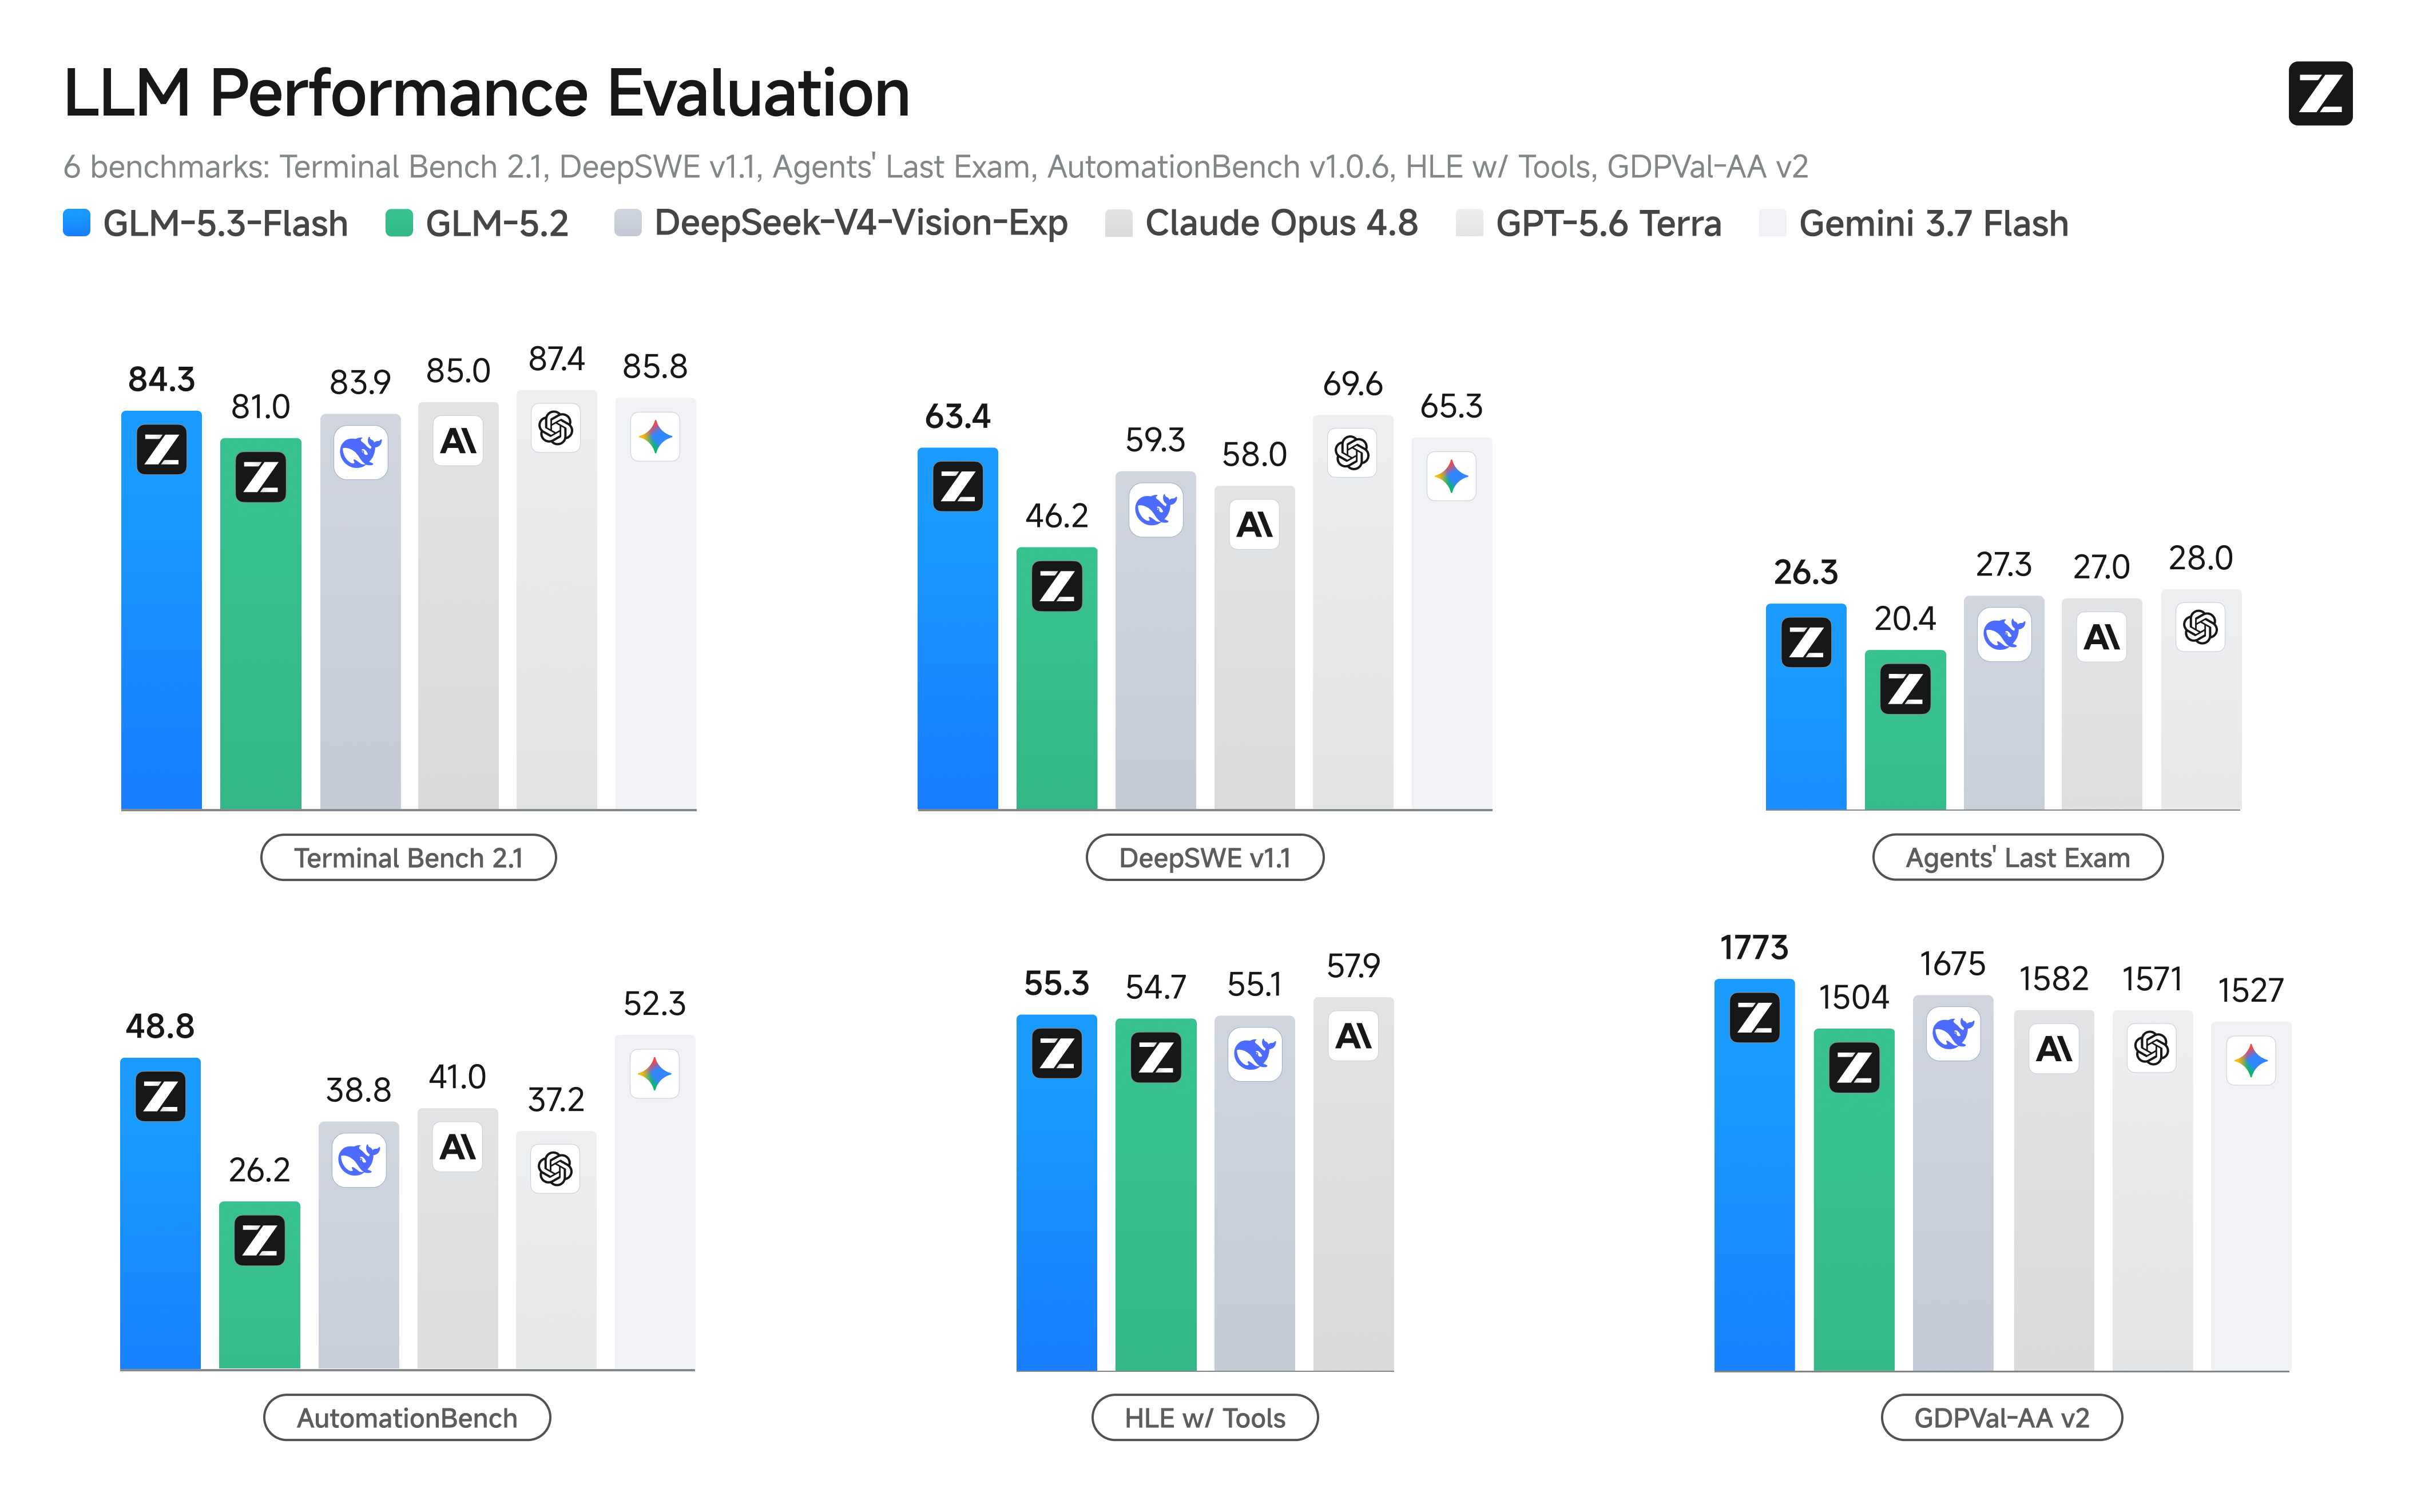
6개 코딩·에이전트 벤치마크에서 GLM-5.2를 일관되게 앞서고 전체적으로 Claude Opus 4.8에 근접함
DeepSWE v1.1은 63.4 대 46.2, AutomationBench는 48.8 대 26.2로 격차가 특히 컸음
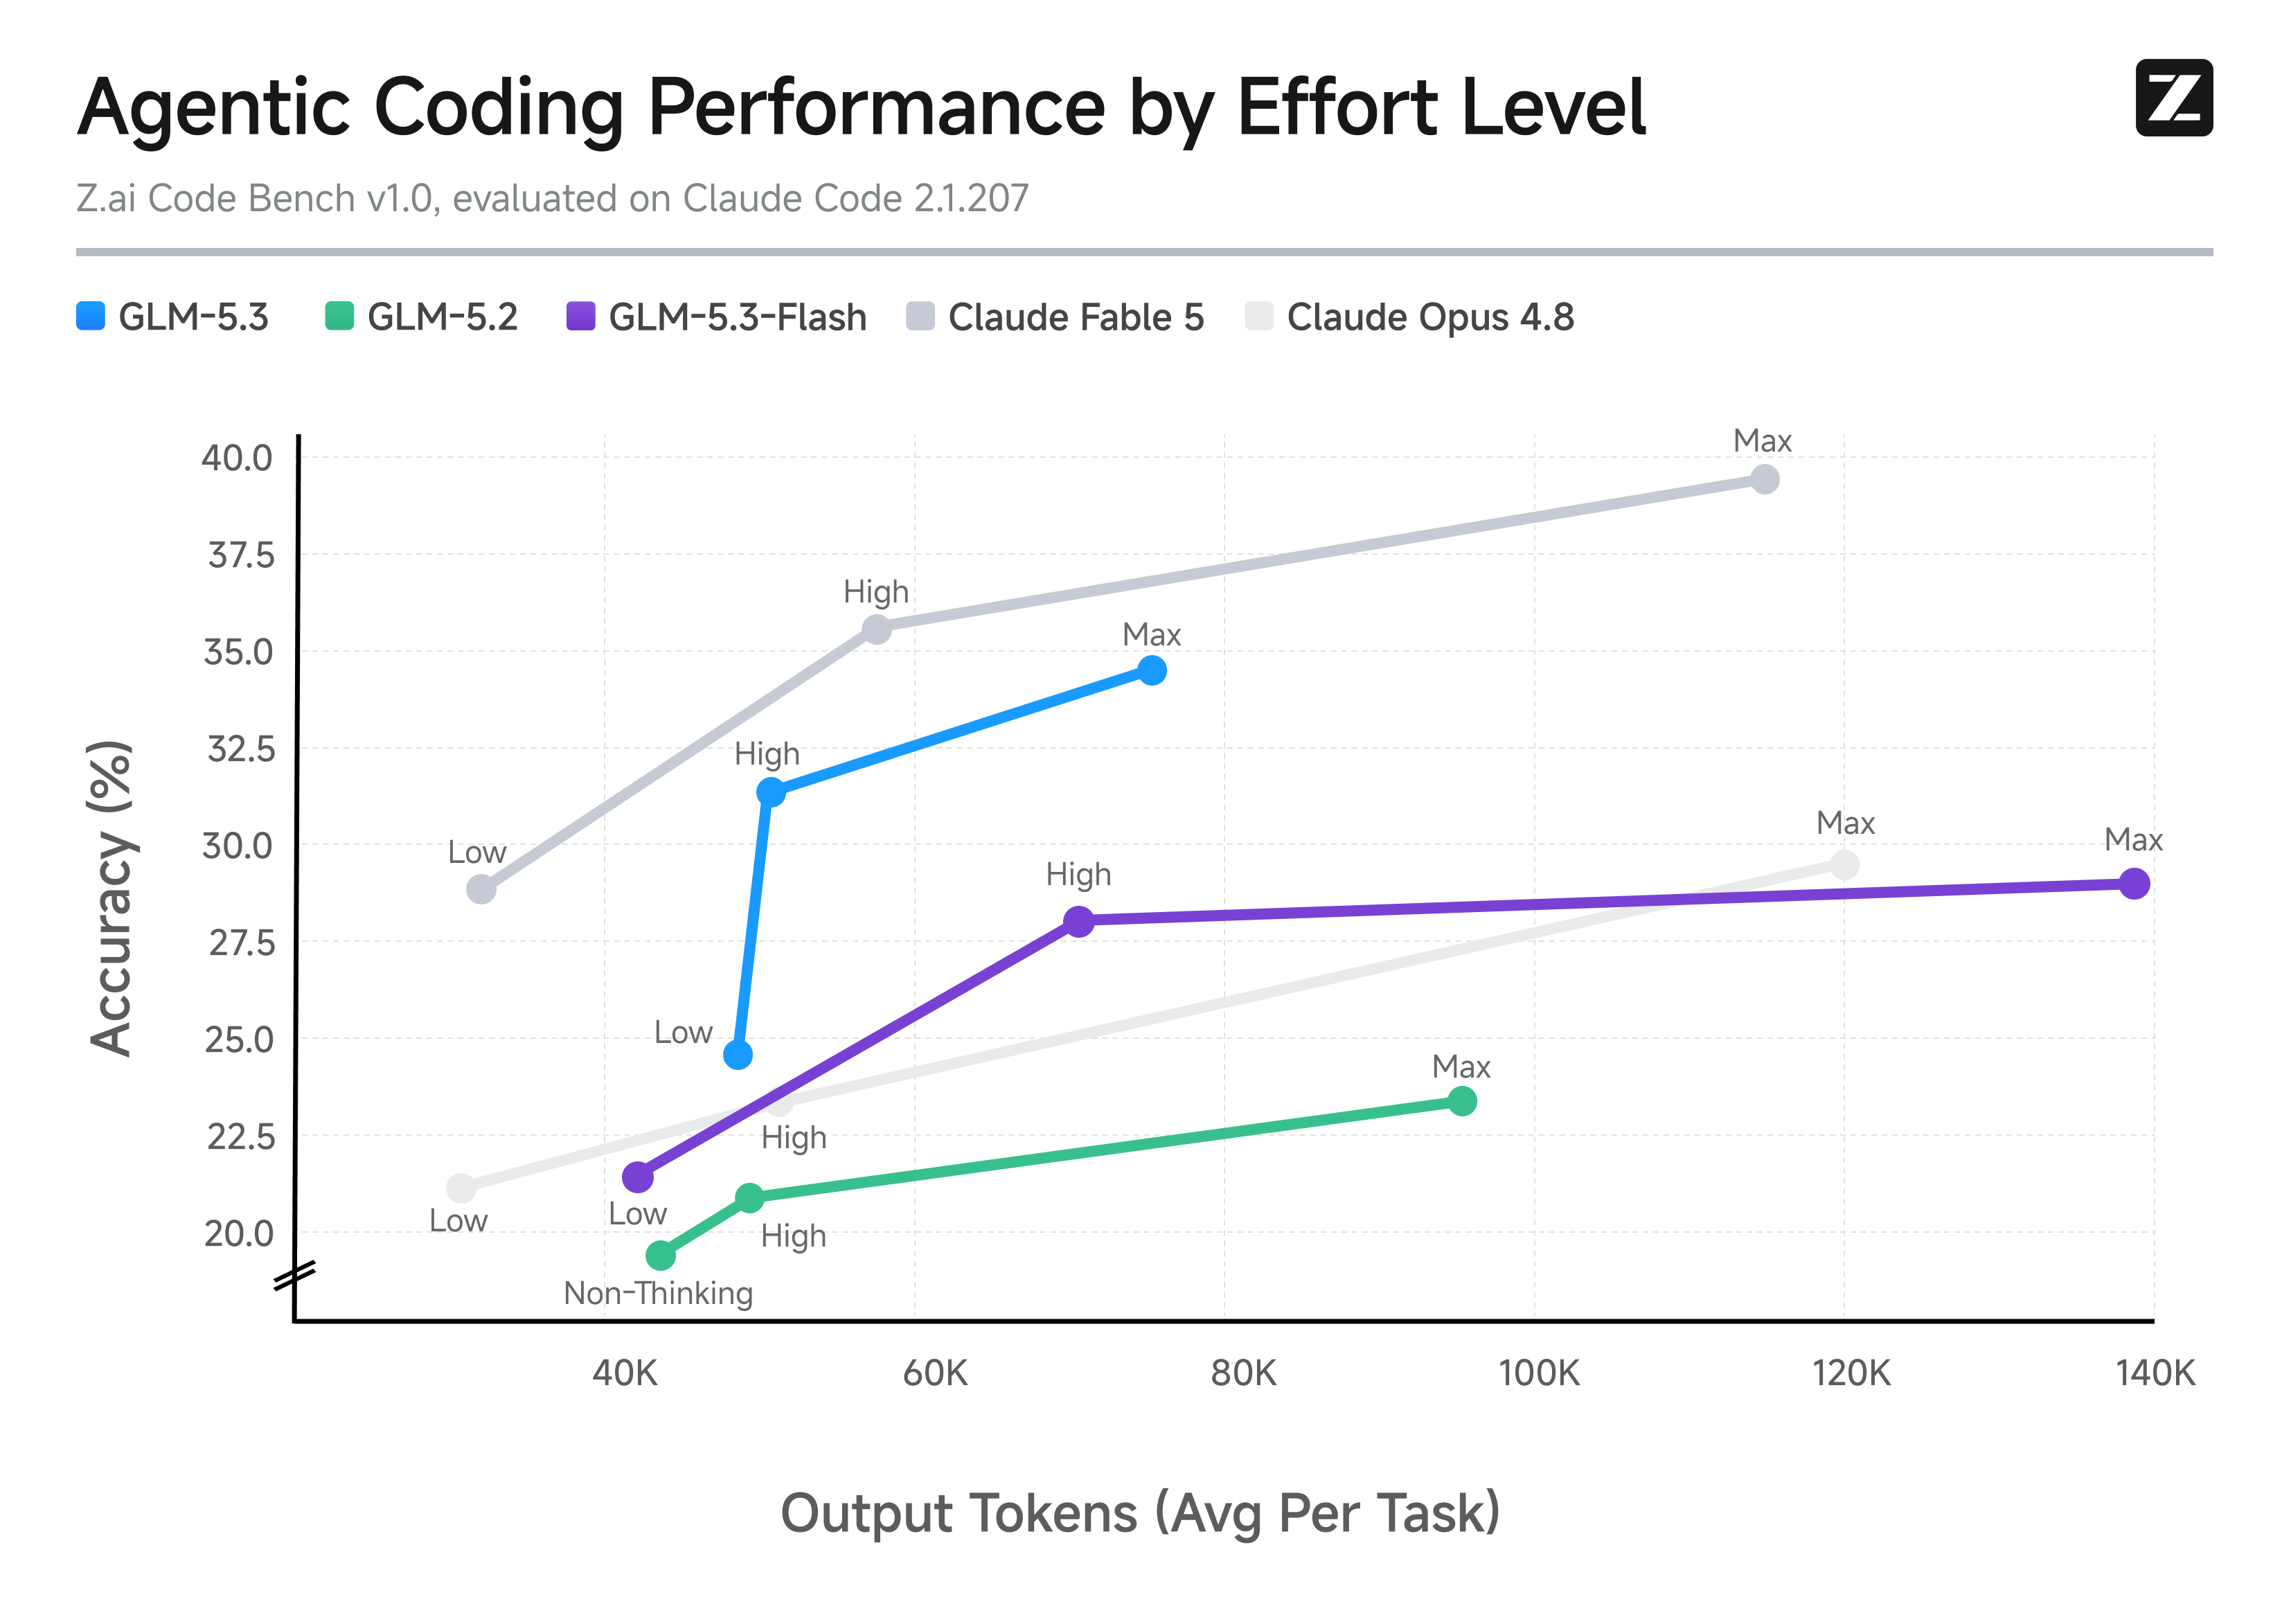
자체 코딩 평가에서도 모든 effort 수준에서 GLM-5.2보다 높은 점수를 기록함
Claude Code 2.1.207로 실행한 Z.ai Code Bench v1.0에서 max effort 점수는 29.0으로 Claude Opus 4.8의 29.5에 거의 도달함
극단적 효율을 위한 아키텍처
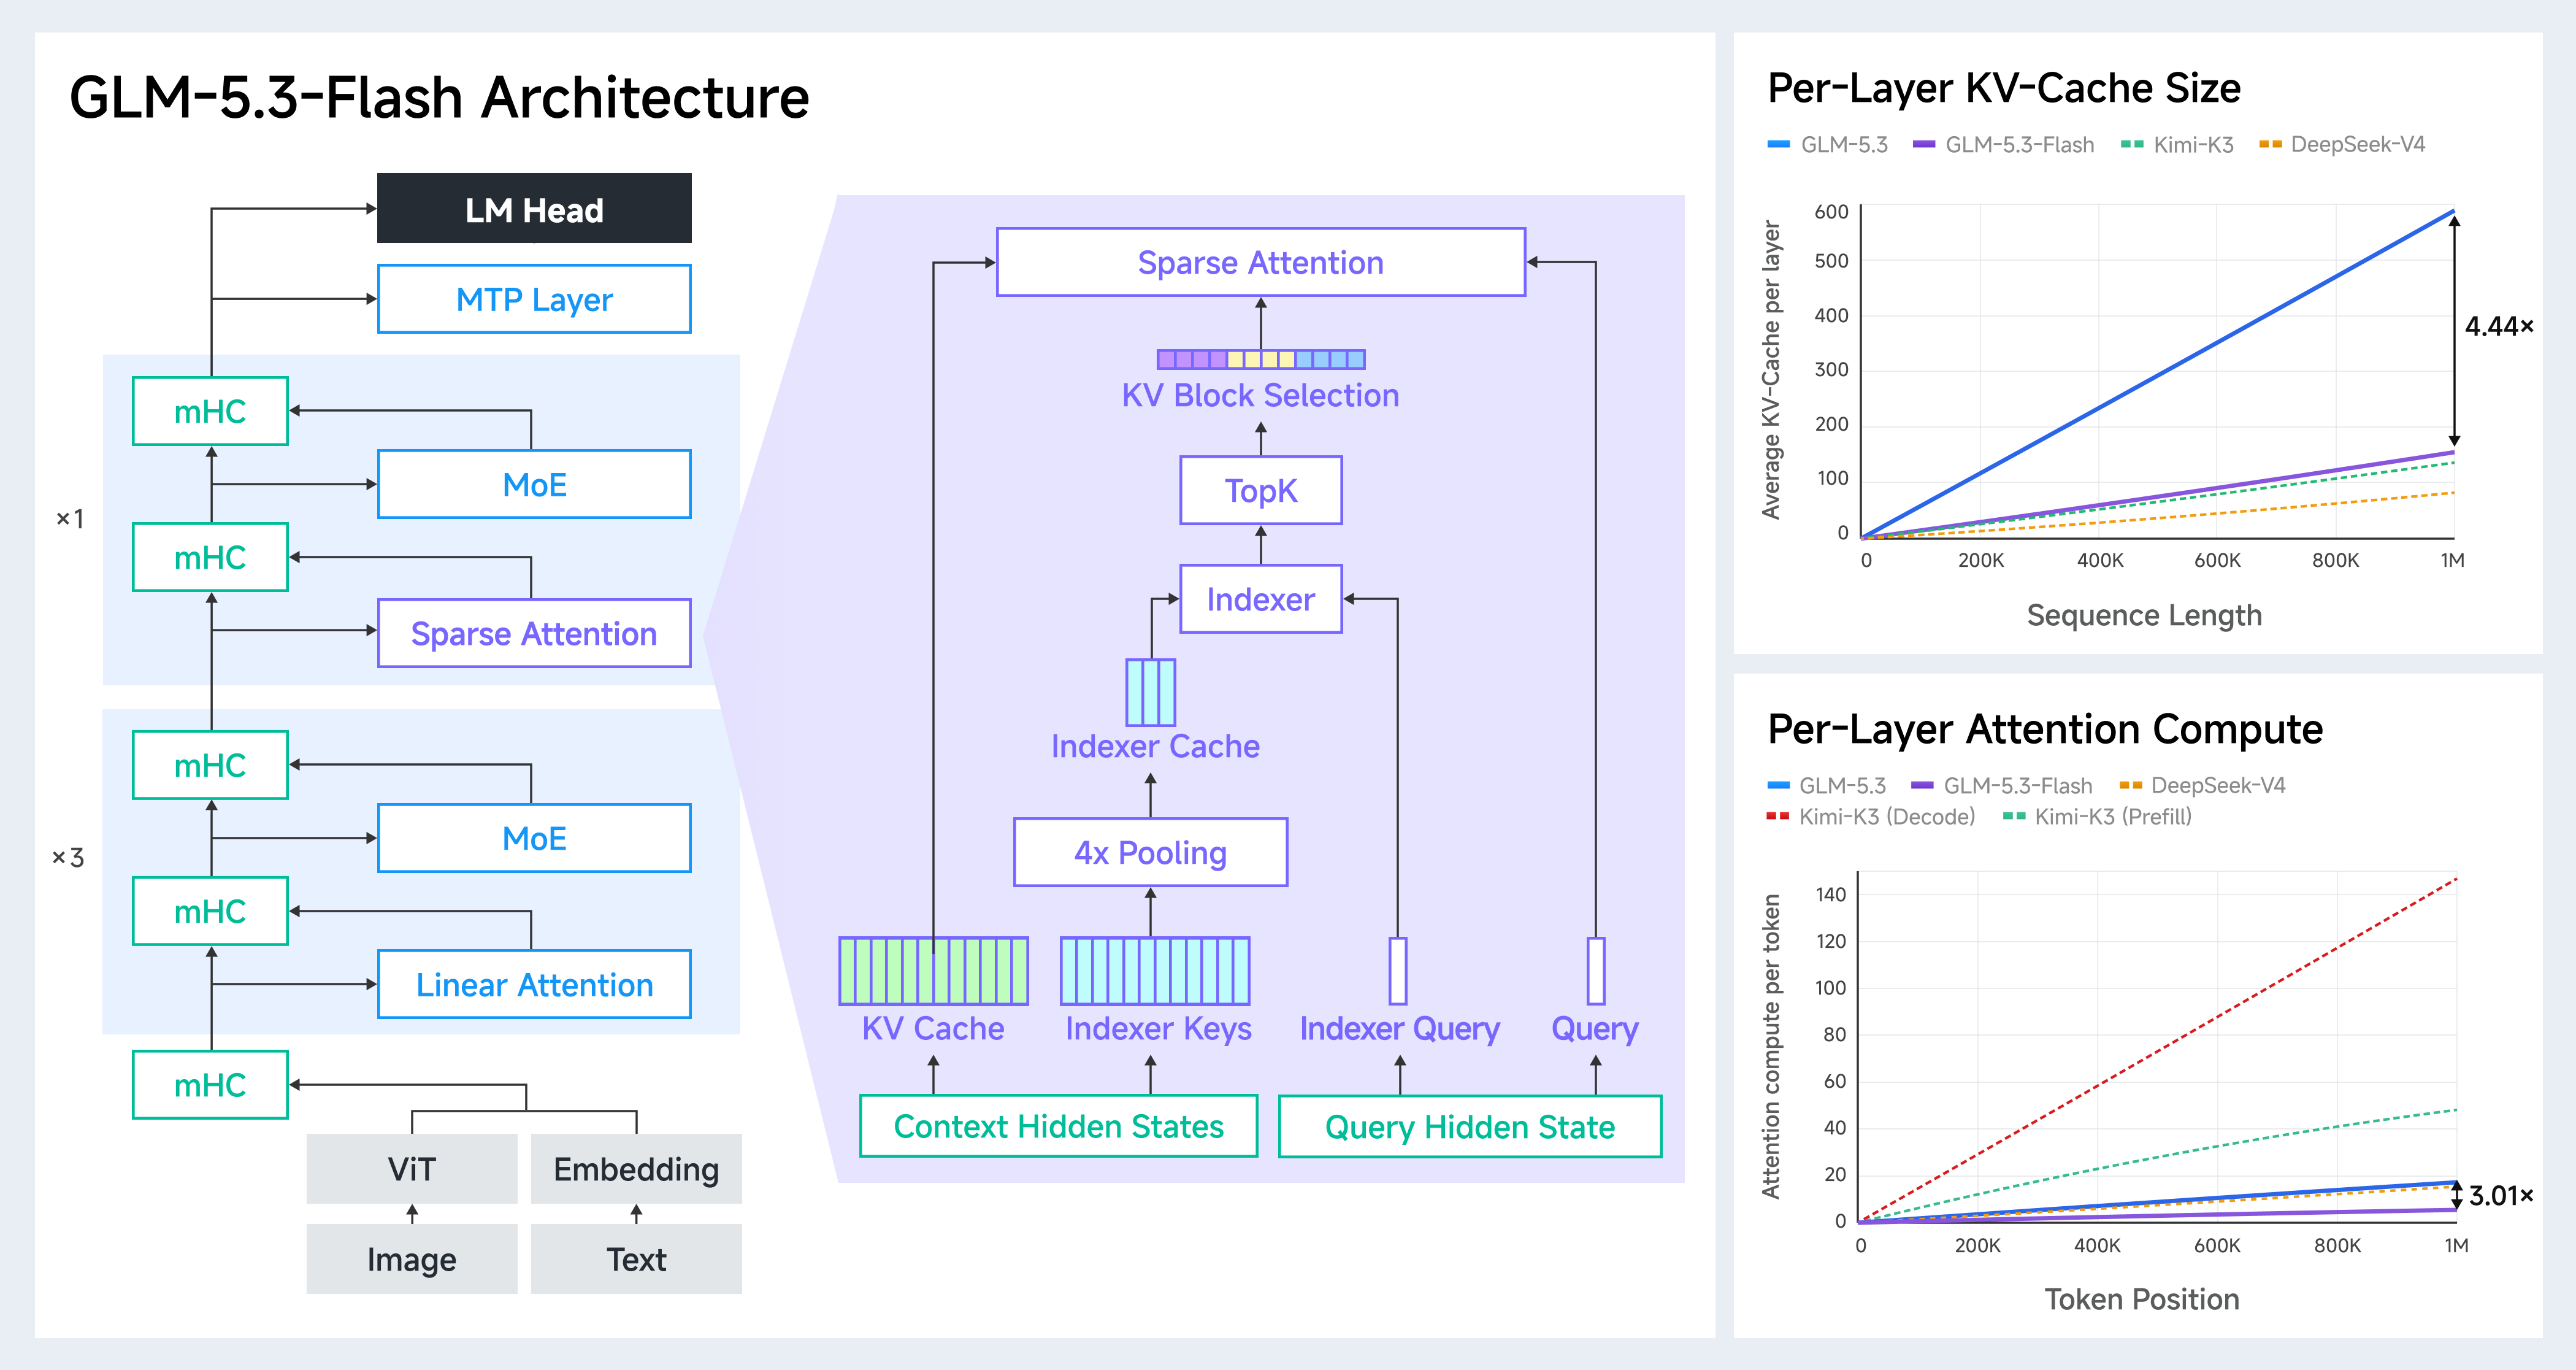
GLM-4.5 시리즈와 총 파라미터 수는 비슷하지만 초저비용 추론에 맞춰 활성 파라미터와 레이어를 거의 절반으로 줄임
총 파라미터는 320B 대 355B인 반면 활성 파라미터는 18B 대 32B, 레이어는 45개 대 92개임
1M-token long-context에서도 attention 비용과 indexer의 지연·메모리 부담을 낮춤
linear attention은 상태 모델링으로 로컬 의존성을 포착하고, sparse attention은 가벼운 indexer로 관련 전역 문맥을 검색함
IndexPool은 indexer key vector 4개를 weighted pooling으로 1개에 압축함
GLM-5.3보다 token당 attention 연산량은 3.0배, KV cache 크기는 4.4배 줄어듦
규모가 다른 모델을 공정하게 비교하기 위해 head·layer당 attention 연산량과 layer당 평균 BF16 KV cache 크기를 계산함
비교 대상인 GLM-5.3, DeepSeek-V4-Flash, Kimi-K3 가운데 attention 연산량은 가장 낮았지만, KV cache는 Kimi-K3와 DeepSeek-V4-Flash보다 조금 커 추가 개선 여지가 있음
기본 모델은 GLM-4.5-Base를 전반적으로 앞서고 대부분의 벤치마크에서 GLM-5-Base와 경쟁 가능한 수준을 유지함
DeepSeek-V4-Flash-Base 결과는 구현 차이를 통제하기 위해 자체 평가 프레임워크로 측정함
Benchmark | GLM-4.5-Base | GLM-5-Base | DeepSeek-V4-Flash-Base | GLM-5.3-Flash-Base |
|---|---|---|---|---|
Activated Params | 32B | 40B | 13B | 18B |
Total Params | 355B | 744B | 284B | 320B |
MMLU | 86.1 | 88.3 | 88.5 | 88.1 |
BBH | 86.2 | 87.4 | 84.9 | 86.6 |
HellaSwag | 87.1 | 88.1 | 85.3 | 87.1 |
LiveCodeBench-Base | 28.1 | 34.4 | 29.9 | 37.6 |
SimpleQA | 30.0 | 36.0 | 31.2 | 33.5 |
코딩 루프에 통합한 시각 지능
코드뿐 아니라 렌더링·상호작용·플레이 테스트 결과를 직접 관찰하고 다음 행동을 결정하도록 vision을 네이티브로 통합함
프런트엔드, 게임, 3D 시뮬레이션의 최종 결과물은 코드만이 아니라 사용자가 경험하는 인터페이스·상호작용·세계이며, 많은 실패는 렌더링하거나 실제로 조작할 때 발생함
CUA까지 적용하면 프로그래밍 가능한 시스템을 넘어 눈에 보이고 상호작용 가능한 환경에서 작업할 수 있음
시각 코딩용 데이터 합성 파이프라인으로 자체 시각 판단과 test-time 개선을 훈련함
모델이 환경과 상호작용하고 자체 결과물을 검사한 뒤 반복적으로 수정하는 trajectory를 구성함
프런트엔드 코딩에는 환경 피드백 기반 강화학습을 실험하고, 실제 사용자 흐름에 근거한 agent-based verification으로 GUI 판단을 강화해 기능 정확성뿐 아니라 렌더링·상호작용 결과까지 검증함
코드는 모델이 세계를 만들고 바꾸게 하며, vision은 사람이 보고 사용하는 세계 안으로 들어가게 함
레이아웃 문제가 있는 초기 버전
시각적 자체 검증 후
코딩을 넘어 업무 파트너로
텍스트·시각·구조적 문맥을 함께 추론해 문서, 스프레드시트, 프레젠테이션, 대시보드, 인터페이스, 회의 자료까지 다룰 수 있음
사용자가 작업 환경을 일일이 텍스트 지시로 바꾸지 않아도 관련 산출물을 직접 해석하고 필요한 정보를 찾아냄
시각적 문맥과 의도한 결과를 기준으로 자체 출력물을 검토·수정하며, 프레젠테이션 품질과 미적 완성도도 더 정확히 판단함
전문 업무 사례로 ‘태양계의 여덟 행성’과 ‘2026 Hospitality Responsibility Report’를 제시함
중국산 AI 칩에서 대규모 서빙
지난 1주 동안 고대역폭 interconnect와 하드웨어 최적화 서빙 스택을 갖춘 중국산 AI 칩 대규모 클러스터에서 서비스를 운영함
개별 칩의 제한된 연산·메모리 용량을 극복하기 위해 SGLang 위에 전용 추론 엔진을 구축함
GLM-5.3 기반 인프라 에이전트가 kernel 개발·최적화, 병목 진단, 서빙 스택 개선을 지원해 모델이 자신을 서비스하는 시스템을 최적화하는 피드백 루프를 만듦
최대 1M-token 문맥에서 메모리 용량과 대역폭 제약을 완화하는 최적화를 적용함
compute-for-bandwidth와 communication-for-bandwidth 기법을 아키텍처에 맞게 조정함
Linear Attention과 LM head용 intra-node tensor parallelism, ReplaySSM, W8A8 quantization, hybrid INT8/FP8/BF16 cache quantization, Layer Split을 결합함
production-grade Encode–Prefill–Decode(EPD) 분리 아키텍처로 수만 개의 중국산 가속기를 효율적으로 운영함
멀티모달 encoding, prompt prefill, token-by-token decoding을 독립적으로 스케줄링하고 확장할 수 있는 worker pool로 분리함
같은 하드웨어의 초기 baseline보다 end-to-end 서빙 성능을 3배 높였고, 주류 NVIDIA GPU와 비슷한 하드웨어 효율 및 token당 비용에 도달함
낮은 비용의 frontier intelligence는 단일 기법이 아니라 세 요소의 결합으로 구현됨
적은 연산으로 역량을 높이는 아키텍처, 더 풍부한 멀티모달 사전 학습 코퍼스, 추론 하드웨어와 공동 설계한 인프라가 함께 작동함
이 방식을 더 큰 모델로 확장하고 있으며, 구축 과정에서 얻은 교훈을 다음 frontier 모델에 적용 중임
이용 방법과 공개 범위
모든 GLM Coding Plan 사용자에게 배포했으며 GLM-5.3보다 사용 가능한 quota가 3배 많음
z.ai 구독 페이지에서 사용할 수 있음
ZCode의 Browser Use와 Computer Use에서 멀티모달 기능을 활용 가능
에이전트가 웹페이지를 직접 클릭하며 시각적으로 검증하고 데스크톱 앱도 조작함
모델 weight를 HuggingFace에 공개함
로컬 배포는 현재 SGLang, vLLM, TokenSpeed를 지원하며 다른 추론 프레임워크는 추후 제공 예정임
코딩·에이전트·vision 벤치마크별 결과는 다음과 같음
Benchmark | GLM-5.3-Flash | GLM-5.2 | DeepSeek-V4-Vision-Exp | Opus 4.8 | GPT-5.6 Terra | Gemini 3.7 Flash |
|---|---|---|---|---|---|---|
Coding | ||||||
Terminal Bench 2.1 | 84.3 | 81.0 | 83.9 | 85.0 | 87.4 | 85.8 |
DeepSWE v1.1 | 63.4 | 46.2 | 59.3 | 58.0 | 69.6 | 65.3 |
NL2Repo | 56.3 | 48.9 | 57.7 | 69.7 | - | - |
Agentic | ||||||
Toolathlon Verified | 78.4 | 59.9 | 75.9 | 76.2 | 74.9 | - |
AutomationBench v1.0.6 | 48.8 | 26.2 | 38.8 | 41.0 | 37.2 | 52.3 |
Agents' Last Exam | 26.3 | 20.4 | 27.3 | 27.0 | 28.0 | - |
HLE w/ Tools | 55.3 | 54.7 | 55.1 | 57.9 | - | - |
GDPval-AA v2 | 1773 | 1504 | 1675 | 1582 | 1571 | 1527 |
Vision | ||||||
OfficeQA Pro | 62.4 | - | 57.9 | 48.9 | - | - |
CharXiv Reasoning w/ Tools | 89.4 | - | 80.4 | 89.9 | 88.0 | 88.7 |
Chartography w/ Tools | 78.0 | - | 64.3 | 75.0 | 68.0 | 65.0 |
BabyVision | 53.4 | - | 35.1 | 46.8 | 61.6 | 70.9 |
MVbench | 77.8 | - | 69.4 | 67.1 | 75.0 | 82.2 |
MMVU | 80.5 | - | 72.7 | 67.4 | 75.8 | 82.3 |
벤치마크별 평가 조건과 제한을 결과에 함께 적용함
코딩·에이전트 평가는 다음 조건으로 진행함
HLE w/ Tools 전체 세트는
temperature=1.0,top_p=0.95, 최대 생성 길이163,840tokens, 최대 문맥300,000tokens와 context management를 사용하고 GPT-5.6-luna(medium)가 판정함NL2Repo는 1M context에서
temperature=1.0,top_p=1.0,max_new_tokens=64k로 평가했으며, 무단 pip·curl 실행 같은 악성 행위를 막기 위해 규칙 기반 및 LLM 기반 판정을 함께 적용함DeepSWE는 mini-swe-agent harness에서
temperature=0.95,top_p=1.0,timeout=6h, 400K context로 실행함Terminal-Bench 2.1은 Claude Code 2.1.207에서
temperature=1.0,top_p=1,max_new_tokens=65536,timeout=6h로 측정함Agents' Last Exam은 공식 평가 프로토콜과 Claude Code harness를 사용했으며 reasoning effort는 max, context는 1M, 최대 출력은 64K로 설정하고 Tool Search를 비활성화한 뒤 공식 ALE evaluator로 채점함
Toolathlon Verified는 공식 평가 서비스에서 얻은 3회의 독립 실행 결과를 pass@1로 평균함
AutomationBench는
nulltype 처리 문제를 고친 PR #13이 반영된 v1.0.6으로 평가했고, GDPval-AA v2는 Artificial Analysis가 측정함
vision 평가는 다음 입력·문맥 조건을 따름
BabyVision은
temperature=1.0,top_p=0.95, 최대 문맥 164K tokens를 사용하고 다른 baseline과 동일하게 입력 이미지의 짧은 변이 최소 1.5K pixels가 되도록 크기를 조정함OfficeQA Pro는 embedded text 접근 없이 Treasury Bulletin PDF corpus로 평가했으며
temperature=1.0,top_p=0.95, 최대 문맥 512K tokens를 적용함CharXiv Reasoning과 Chartography는 각각
temperature=1.0,top_p=0.95, 최대 문맥 256K tokens로 실행함MVBench와 MMVU도
temperature=1.0,top_p=0.95, 최대 문맥 256K tokens를 사용하며, Gemini 3.7 Flash처럼 video를 네이티브로 받는 모델에는 raw video를 입력하고 나머지는 기본 1 fps로 frame을 추출함. 추출 frame 수가 API 최대치를 넘으면 전체 video에서 최대 수까지 균등 sampling함
source https://z.ai/blog/glm-5.3-flash
HN에서는 GLM-5.3-Flash의 낮은 가격과 공개 가중치보다, 벤치마크 성능이 실제 개발 작업에서도 이어지는지가 핵심 쟁점이었다. 익명으로 제공된 ox-alpha가 좋은 반응을 얻었고, 복잡한 UI 리팩터링이나 일상적인 코딩에 충분했다는 경험도 나왔다. 반면 장시간 작업에서 오류가 나거나 맥락을 잃었고, 제안한 편집 내용을 하나도 채택하지 못했다는 사용자도 있었다.
이 온도 차이는 모델 평가 기준에서 비롯됐다. 짧고 정답이 분명한 과제에서는 비용 대비 성능이 돋보이지만, 요구사항이 모호하거나 긴 시간 자율적으로 진행해야 하는 작업에서는 대형 모델과 차이가 난다는 지적이다. 같은 개발 도구를 써도 반복 횟수, 도구 호출의 안정성, 장기 작업의 일관성이 생산성을 좌우한다. 비교 대상과 할인 가격을 유리하게 배치한 발표 자료, 축을 잘라 차이를 부풀린 그래프도 검증이 필요하다는 반응이 뒤따랐다.
로컬 실행을 바라보는 시각도 엇갈렸다. 4비트 양자화로 구동할 수는 있지만 큰 메모리와 상당한 장비 비용이 필요하다. 사용량 제한 없이 구현과 테스트를 계속 돌리는 고사용량 환경이라면 투자를 검토할 만하다는 계산이 나온 한편, 실제 처리량과 전력·유지비, 빠른 하드웨어 세대교체를 감안하면 비용 회수 수단으로 보기는 어렵다는 반론도 설득력을 얻었다. 프런티어 모델은 계획에 쓰고 로컬 모델은 반복 실행에 맡기는 혼합 구성이 현실적인 대안으로 제시됐다.
업데이트
가격(1M)
모델 | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
GLM-5.3-Flash 현재 할인가 | $0.075 | $0.015 | $0.25 |
GLM-5.3-Flash 정가(Artificial Analysis 기준) | $0.15 | $0.03 | $0.50 |
GPT-5.6 Sol, 입력 ≤272K | $4.00 | $0.40 | $20.00 |
GPT-5.6 Sol, 입력 >272K | $8.00 | $0.80 | $30.00 |
Claude Opus 5 | $5.00 | $0.50 | $25.00 |
Claude Fable 5 | $10.00 | $1.00 | $50.00 |
Gemini 3.7 Flash, | $0.75 | $0.075 | $3.75 |
Gemini 3.1 Pro Preview, 입력 ≤200K | $2.00 | $0.20 | $12.00 |
Gemini 3.1 Pro Preview, 입력 >200K | $4.00 | $0.40 | $18.00 |
