Gemini 3.7 Flash 출시
2026년 8월 13일, 코딩과 에이전트용 주력 모델을 출시함
널리 사용되는 Flash 시리즈를 확장한 모델로, Gemini 3.6 Flash 출시 3주 만에 개발자 피드백과 알고리즘 혁신을 반영해 선보임
소프트웨어 엔지니어링·지식 업무·웹 개발 워크플로 전반을 크게 개선했으며, 토큰 100만 개당 도입 가격은 기존 3.6 Flash 가격의 절반으로 책정됨
복잡한 워크플로의 지능 향상
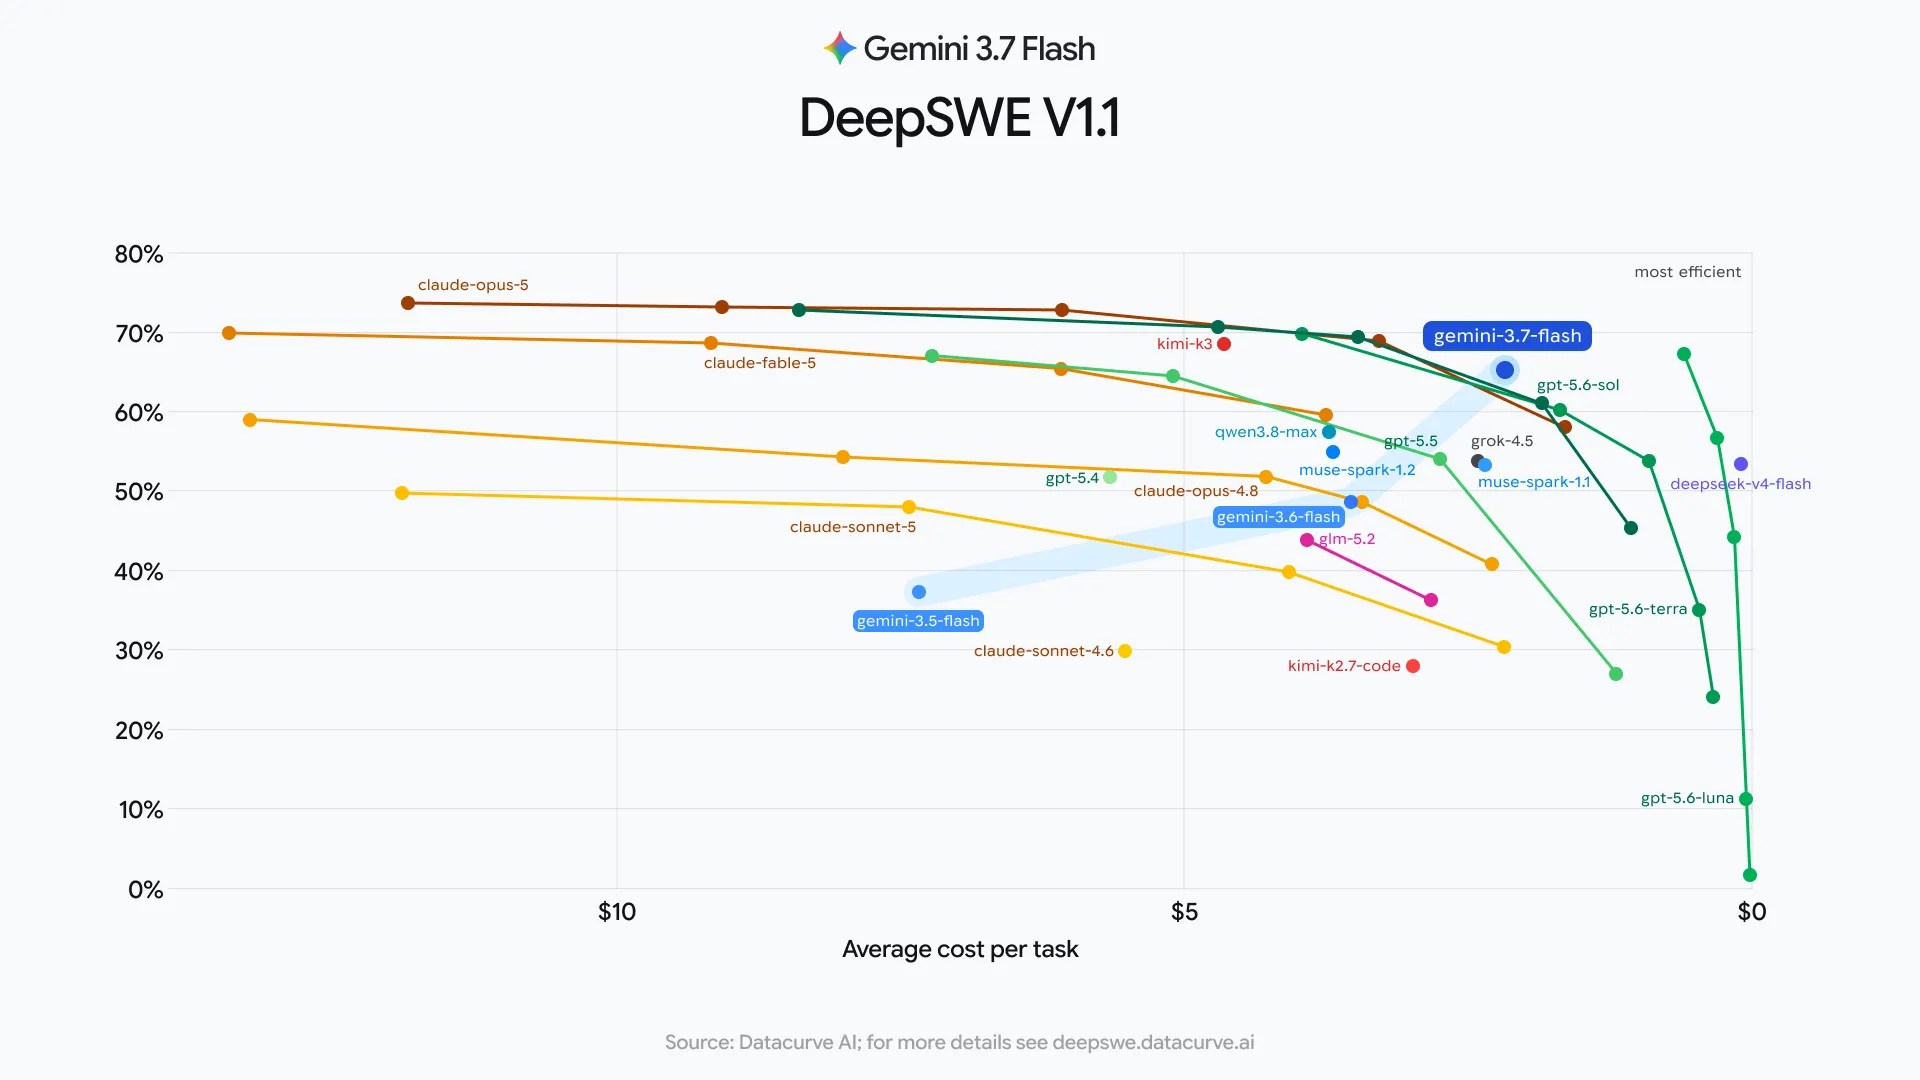
디버깅과 문제 해결에서 더 정확하고 실전적인 코드를 생성함
첫 시도 코드 정확도와 프로덕션 수준 코드 생성 성능이 높아짐
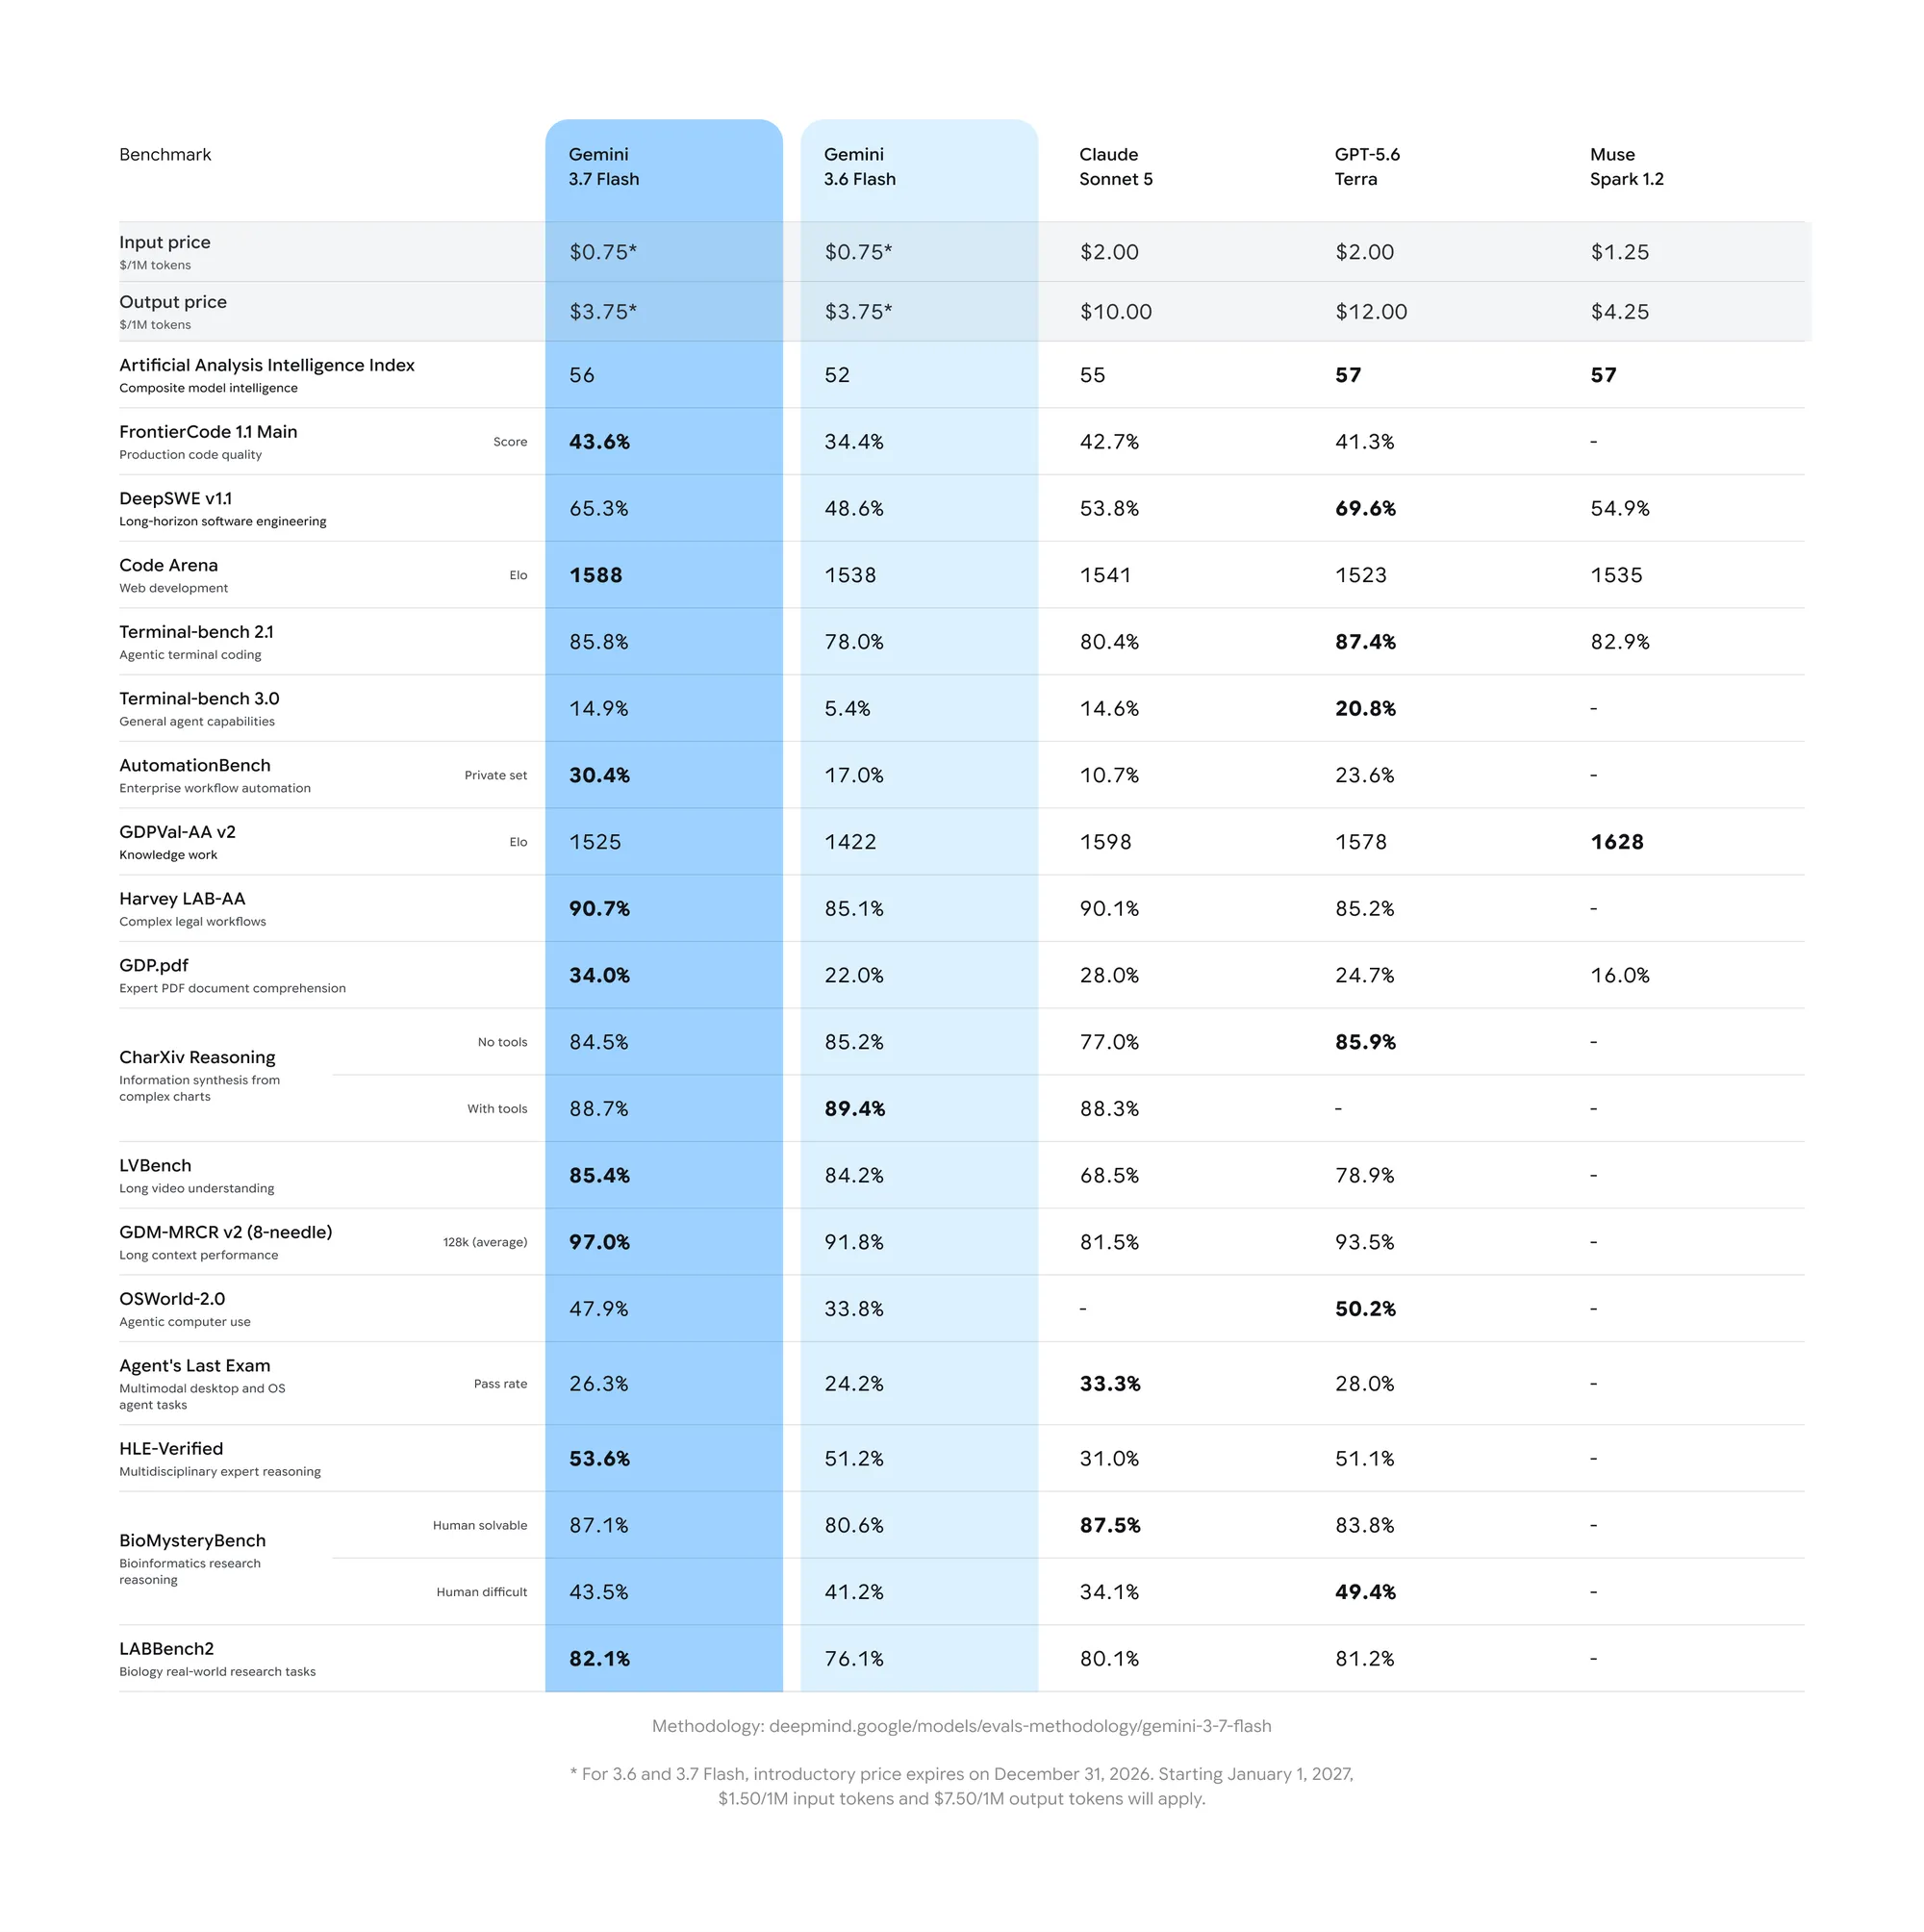
FrontierCode 1.1 Main: 43.6%로 3.6 Flash의 34.4%를 상회
DeepSWE v1.1: 65.3%로 49.0%보다 향상
웹 개발에서 더 적은 프롬프트로 기능적인 레이아웃과 완성도 높은 앱을 제작 가능
스크린샷·이미지·전체 디자인 시스템을 참조한 UI 생성에서 디자인 지침을 충실히 따르며 원본과 대등한 결과를 제공함
Arena.ai의 WebDev Arena Elo 점수는 1588로, 3.6 Flash의 1538보다 높음
금융·법률·생명과학처럼 지식 밀도가 높은 분야의 추론과 정확도가 개선됨
복잡한 문서 처리 능력을 평가하는 GDP.pdf 벤치마크에서 34.0%를 기록해 3.6 Flash의 22.0%를 앞섬
실제 비즈니스 워크플로 완료 능력을 측정하는 AutomationBench에서는 30.4%로 17.0%보다 향상
멀티모달·에이전트 조합으로 복잡한 결과물을 생성하는 사례를 구현함
Nano Banana와 결합해 간단한 텍스트 프롬프트만으로 캐릭터·아이템·텍스처를 실시간 생성하는 완전한 3D 게임을 제작 가능
하위 에이전트를 조율하고 Gemini Omni로 부드러운 인터랙티브 패럴랙스 구성 요소를 만들어 랜딩 페이지를 한 번에 생성함
멀티모달 이해를 활용한 3개 에이전트 그래프 루프로 로봇 학습 속도를 높이는 훈련 모델에 적용
정적인 연차보고서 PDF를 실시간 차트와 종합 인사이트가 포함된 인터랙티브 데이터 스토리로 변환 가능
개발 경험과 가격
다단계 계획과 도구 호출을 더 신중하고 일관되게 수행함
장애물에 더 잘 적응하고 필요할 때 의도를 확인하며 지시를 충실히 따름
실행이 체계화돼 엔지니어링 워크플로에서 수동 감독과 재시도 횟수가 줄어듦
도입 가격은 2026년 말까지 입력 100만 토큰당 $0.75, 출력 100만 토큰당 $3.75임
향상된 성능과 낮은 가격을 결합해 프로덕션용 에이전트를 비용 효율적으로 확장 가능
초기 고객 사용에서는 낮은 비용으로 3.6 Flash보다 크게 향상된 성능과 정밀도를 보임
Gemini Spark 개선
160여 개국의 Google AI Pro·Ultra 구독자용 Gemini Spark에 출시 당일부터 적용됨
Spark는 사용자의 지시에 따라 24시간 대신 작업을 수행하는 개인 AI 에이전트로, 이번 업데이트를 통해 Google Workspace 앱의 도구 활용이 개선됨
복잡한 다중 기술 워크플로에서 정확도와 결과물 품질이 높아지고, 파일 통합·이메일 초안 작성·상태 문서 업데이트를 더 효율적으로 처리 가능
안전성
Frontier Safety 보호 체계의 적용 범위와 견고성을 계속 강화함
생물학적 회복탄력성 접근법과 사이버 프로그램에 따라 유익한 활용은 지원하면서 화학·생물학·방사능·핵(CBRN) 및 사이버 공격 분야의 오용 방지 장치를 업데이트함
자세한 안전성·성능 정보는 3.7 Flash 모델 카드에서 확인 가능
HN에서는 Gemini 3.7 Flash를 평가할 때 빠른 응답과 멀티모달 성능을 높이 살지, 경쟁 모델 대비 가격과 결과물의 신뢰성을 더 엄격히 따질지를 놓고 시각이 갈렸다. 자동화나 짧은 개발 반복처럼 지연 시간이 곧 사용성으로 이어지는 작업에서는 속도가 뚜렷한 장점으로 꼽혔다. 이미지 이해와 OCR, 요약, 화면 시안을 활용한 코드 생성도 강점으로 언급됐다.
그러나 복잡한 리팩터링이나 장시간 이어지는 개발에서는 결과를 그대로 믿기 어렵다는 경험도 적지 않았다. 실행되지 않는 코드나 존재하지 않는 API를 내놓고도 작업을 마쳤다고 보고하는 문제가 지적됐다. 이미지 기반 HTML 생성 사례에서는 겉보기 결과가 준수했지만 특정 브라우저에서 SVG가 깨졌고, 같은 입력을 받은 이전 버전보다 기능 구현이 부실했다는 시험도 나왔다. 벤치마크 상승이 실제 완성도를 보장하지는 않는다는 얘기다.
가격 역시 토큰 단가만으로 판단하기 어려웠다. 더 저렴한 경쟁 모델이 많다는 지적에 맞서, 모델마다 작업에 쓰는 토큰량이 달라 작업당 비용을 비교해야 한다는 반론이 나왔다. 다만 연말까지만 제공하는 할인은 모델 교체 주기가 짧은 시장 현실과 맞지 않는다는 반응이 많았다. API 키 발급과 클라우드 설정, 복잡한 상품 체계도 도입 부담으로 꼽혔다.
짧고 명확한 작업이나 대규모 자동화, 사용자 대기 시간이 중요한 기능이라면 실제 처리 속도와 작업당 비용을 측정해볼 만하다. 반대로 긴 문맥과 복잡한 코드 수정이 필요한 경우에는 실행 여부, 오류 수정 능력, 완료 보고의 정확성을 자체 평가해야 한다. 같은 입력으로 이전 버전과 경쟁 모델을 비교하고 설정 부담까지 계산해야 실무에 맞는 선택을 할 수 있다.
