챗지피티에 "1~30중에 아무 숫자나 골라봐" 17, 23만 나온다고? 왜 그럴까?
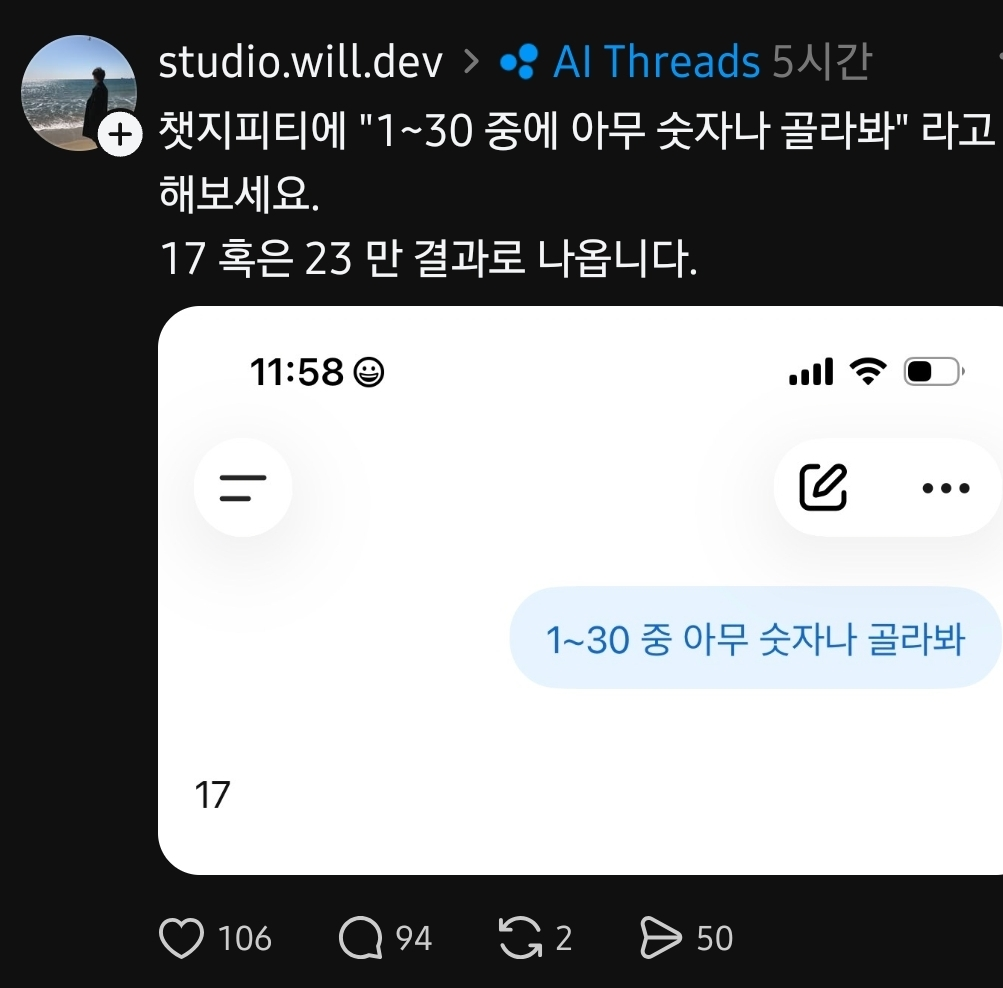
“1~30 중에 아무 숫자나 골라봐”라고 하면 실제로 17과 23이 높은 확률로 등장함
LLM의 동작 원리를 알면 쉽지만 이미 LLM 관련 설명이 많으므로 이부분은 패쓰…
(LLM = 많은 데이터에서 배운 패턴을 이용해, 지금까지의 문맥 다음에 올 토큰들의 확률을 계산하고 하나씩 선택하면서 답변을 만드는 초대형 자동완성 모델)
암튼 예전에는 이런 Prompt를 넣었을 때 결과로 나오는 토큰들의 확률을 볼 수 있게 OpenAI Playground에 아래와 같은 UI가 있었음 (지금은 없어짐)
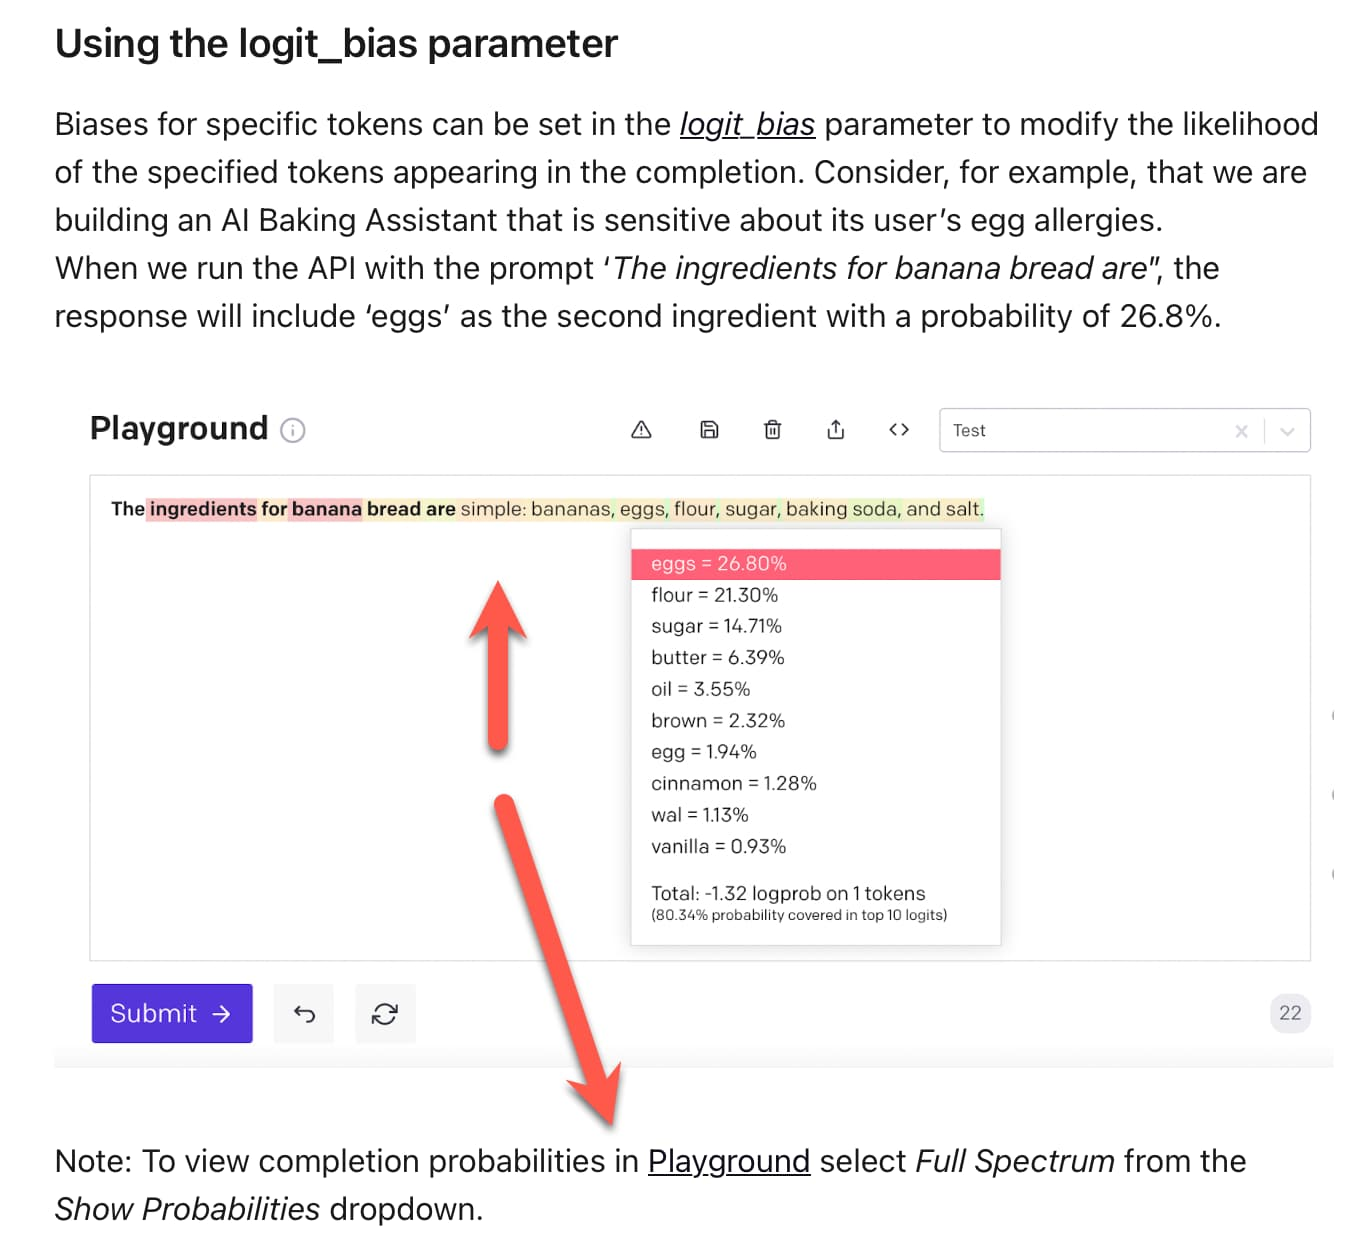
그래서 확인해보려면 API에 top_logprobs 를 활성화 해서 호출하면 각 응답 토큰에 대해 토큰이 선택될 확률을 볼 수 있음
{
  "model": "gpt-5.6-sol",
  "reasoning": { "effort": "none" },
  "top_logprobs": 20,
  "include": ["message.output_text.logprobs"],
  "top_p": 1.0,
  "max_output_tokens": 16,
  "store": false,
  "text": { "verbosity": "low" }
}
각설하고 실행 결과부터 보자
실제 사용한 프롬프트 | 실제 출력 | 주요 첫 토큰 후보 확률 |
|---|---|---|
| 17 | 17: 99.998900% |
| 7 | 7: 99.954610% |
| 23 | 23: 99.810580% |
| 23 | 23: 81.688006% |
| 23 | 23: 98.757286% |
| 17 | 17: 95.256303% |
추측하기에는 사람들에게 “무작위 숫자를 골라 보라”는 말을 했을 때 17처럼 범위 중간에 있고 홀수이며 소수인 숫자를 자주 골랐을 확률이 높다. LLM은 사람의 글에서 이런 패턴을 많이 배웠기 때문에, 실제 난수처럼 각 숫자에 3.33…%씩 주지 않고 17을 높은 확률로 다음 토큰으로 판단한 것으로 보임
“행운의 숫자”를 넣은 결과를 보면 어느정도 감을 잡을 수 있음
여러 문화와 글에서 7은 대표적인 행운의 숫자로 자주 등장하기 때문에 프롬프트에 “행운”이라는 단어가 들어가면 모델은 당연히 17보다 7을 훨씬 자연스럽다고 판단함
쓸데없는 짓 하고 퇴근-